
转载与翻译声明
本文译自 Maxim Khailo 的文章 Your Agentic Workflow’s Cache Keepalive Costs 8x Too Much (v2: the interval frontier)。
- 原文标题:Your Agentic Workflow’s Cache Keepalive Costs 8x Too Much (v2: the interval frontier)
- 原文作者:Maxim Khailo
- 原文出处:blog.mempko.com
- 发布时间:2026-07-24
- 翻译说明:原文版权归 Maxim Khailo 所有。本文为完整中文翻译,图表与引用链接均保留原样,仅供学习交流;如原作者有异议将立即删除。
关于勘误:原文写于 2026 年 7 月,测的是当时的型号与价格。我在文末补了一整节 【2026 现状:今天实际怎么做】——因为这篇文章最有价值的部分(测量方法、盈亏平衡公式、间隔前沿)不会过时,但里面的价格、TTL 和型号一个季度就可能全变,而照抄别人的间隔恰恰是原文自己最反对的做法。批注部分是我的,不代表原作者观点。
目录
- 一、吞噬缓存的停顿
- 二、各家的缓存究竟死在哪里
- 三、间隔才是全部
- 四、付费区间,实测
- 五、超过 TTL,ping 会变成毒药
- 六、什么是确定的,什么是我相信的
- 七、策略
- 八、2026 现状:今天实际怎么做
- 附:参考
更新说明:补上了完整的保留曲线和「间隔前沿」——keepalive 在 Anthropic 和 OpenAI 上、在各自「付费区间」内都能省钱;OpenAI 的最优间隔是 8 分钟而非 4 分钟;而间隔一旦超过 TTL 会主动变成负收益:每次 ping 都在按全价重新 prefill 一个已经死掉的缓存。
一个每个 agent 开发者都认同的优化,几乎所有人都用错了参数。
惯例是每 30 秒 ping 一次。这个惯例多花了 8 倍的钱。
我测量了 Anthropic、OpenAI、Gemini、DeepSeek 四家的 keepalive 经济性,用的是一套能自证时序精度的测试装置。数据推翻了我的几个成见。正确间隔大约是 4 分钟,不是 30 秒。
keepalive 到底省不省钱?取决于提供商,也取决于你的 agent 停顿多久。规则是:只有在「停顿长于该提供商的逐出点、又短于其盈亏平衡线」时才值得保温。在这个窗口内 keepalive 是赚的。在 Anthropic 和 OpenAI 上它确实省钱;在 DeepSeek 和 Gemini 上它只买到延迟。窗口之外,纯属浪费。
一、吞噬缓存的停顿
Prompt 缓存是 API 里最划算的买卖之一:发一个服务器刚处理过的前缀,你只付约十分之一的输入价格,还省掉大部分 prefill 延迟。但缓存几分钟就过期,而 agentic 工作负载是它最糟糕的用户。
Agent 会思考、行动、等待。它发一个请求,跑一次构建/测试套件,或者等人类审批十分钟,然后才发出那条本可以复用(如今已很大的)会话前缀的后续请求。停顿活过了缓存。后续请求付全价、担全额延迟。在 agent 的规模上,这是一笔实打实的账。
防御方法众所周知:停顿期间用定时器重发完全相同的前缀,每次读取都会刷新 TTL。Aider 在 2024 年就上线了这个功能,Anthropic 文档也推荐,社区文章在纸面上算清了 Anthropic 的成本机制、甚至算出了 4 分钟间隔。民间智慧其实拿到了部分正确答案——缺的是测量。
在此之前,人们用算术去猜最优 keepalive。以下全部是我的实测:既确认了社区为 Anthropic 找到的最优时间,也测了其他头部提供商。四家提供商、空闲间隔测到 40 分钟、ping 间隔测到 15 分钟、三次独立运行、每次调用在测试装置内打时间戳。
灵感来自我在 Bellevue 的一间会议室——在 AgentSys 听 Haiying Shen 和 Simon Peter 讲他们的 CacheWise(面向编码 agent 的 KV-cache 管理研究)。他们的 trace 分析从服务端视角精确呈现了上面这个问题:agent 会话复用巨大的前缀,而朴素的逐出策略会毁掉它们。他们的问题是服务器该如何为 agent 管理缓存;我的问题变成了客户端自己能为这件事做什么。Keepalive 就是客户端的答案,这项研究是我对灵感的致谢。
二、各家的缓存究竟死在哪里
要知道 keepalive 值不值,得先知道缓存本来会在什么时候死。所以我让空闲前缀放着不管、不开 keepalive,把「命中率」测到 40 分钟。命中率 = 空闲期间提供商仍让你的缓存保温的概率。
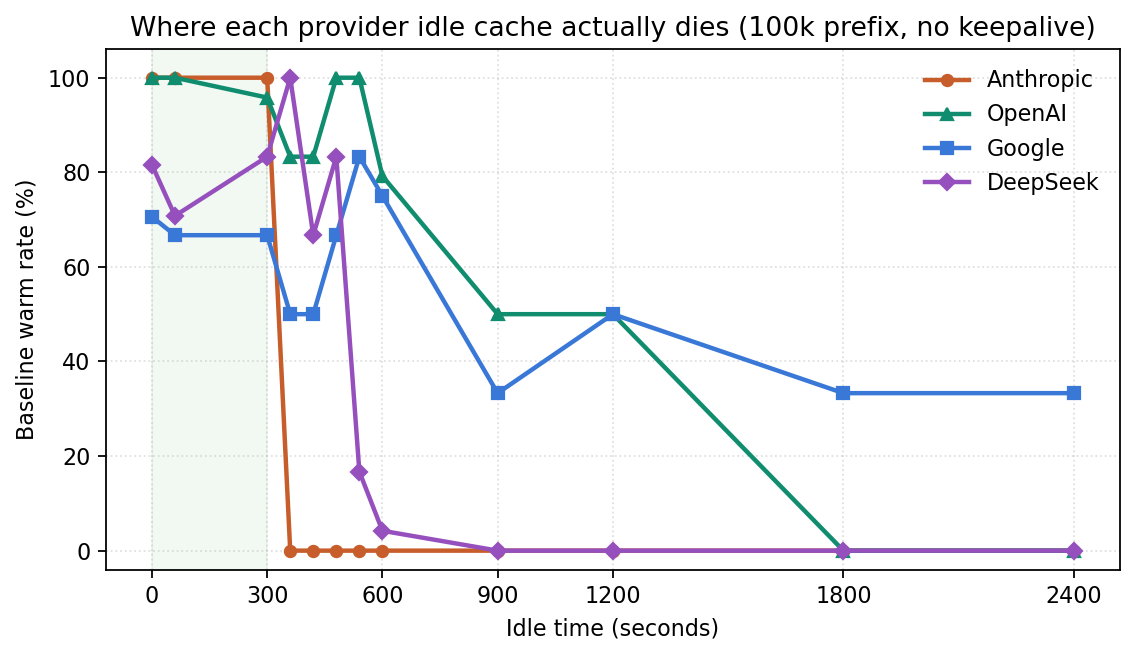
无 keepalive 时的空闲缓存存活曲线,100k 前缀。绿色区间是所有提供商都还保温的窗口。
曲线掉出两件事,两件都重要。
第一:文档标称的 TTL 就是你唯一能依赖的,一分不多。 没有任何缓存早于文档 TTL 被逐出,也没有任何东西在 TTL 之后还有保证。
- Anthropic 的缓存在 5 到 6 分钟之间断崖式下跌,正好卡在它宣称的 5 分钟 TTL。没有宽限期。
- DeepSeek 到 10 分钟就没了。
- OpenAI 实际活得比它文档写的 5–10 分钟更久,20 分钟时还有一半热,30 分钟完全冷掉。是个惊喜,但没法拿来做计划。
- Google 根本没有收敛,每个间隔点上都悬在 33%–83% 的命中率。那不是保留曲线,那是路由抽奖。
所以默认可以假设的保留窗口 = 你这一堆里最短的文档 TTL,再减一点余量。低于它的热度在我所有测量中都成立,高于它的全靠运气。
第二,这条修正了我自己早先的结论:OpenAI 不是「粘」,它只是「慢」。 我第一次只测到十分钟,OpenAI 看起来永不逐出。它其实会逐出,我只是没等够久。这个区别最终决定了 keepalive 对它到底值不值。
Keepalive 本身在哪儿都有效,这点从来不成问题。基线掉下去的地方,keepalive 都把同一个前缀保住了:
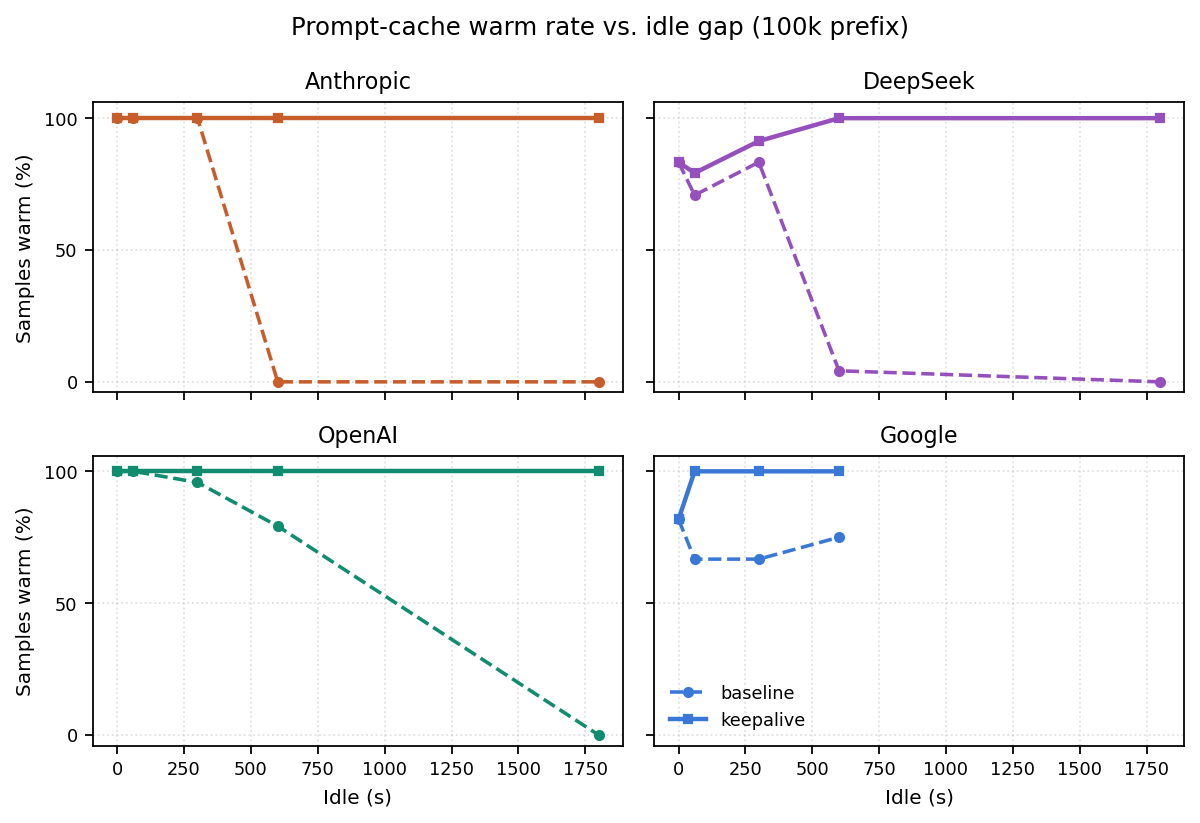
基线(虚线)vs keepalive(实线)命中率,100k,测到 30 分钟。Anthropic:无 keepalive 时十分钟内 48 个样本 0 个热;有 keepalive 时 40/40 全热。每个会逐出的提供商都被保到 100%。
这里「基线」指的是不开 keepalive,提供商会在一段时间后逐出缓存。真正的问题从来不是 keepalive 有没有用,而是值不值得付钱——这取决于你在上面那条保留曲线的哪个位置。
三、间隔才是全部
Keepalive 的完整经济学,是几行算得清的数:
- 一次 ping 每间隔 τ 付一次读取价(≈输入的 10%)。保住一个前缀的成本是 0.1× / τ。
- 一次重新 prefill 一次性付 100%(Anthropic 是 125%,因为它对缓存写入计费)。重新 prefill 发生在缓存已被逐出、提供商需要重做 prefill 的时候。
- 所以每小时花费按 1/τ 下降,间隔本身除了安全性什么都不买。最优间隔 = 最大的、安全低于提供商保留期的那个:Anthropic 5 分钟 TTL 下约 4 分钟。(记住这点;最后一节会讲「安全低于」到底值多少,以及越界会发生什么。)
- 盈亏平衡:空闲时长 ≈ τ(w/r − 1)。按 Anthropic 的价格约 46 分钟,OpenAI 和 DeepSeek 是 36 分钟,Google 是 12 分钟(它的缓存读取是 0.25×,不是 0.1×)。超过这条线就别再 ping 了:让缓存死掉,回来付一次重新 prefill。
最后这条是值得理解的规则。把每次 ping 看成你为避免一次重新 prefill 而付的钱。Anthropic 上 ping 成本是输入价的 0.1×,重新 prefill 是 1.25×,也就是一次重新 prefill 约等于十二次 ping。每 4 分钟付一次 ping,大约十一次之后重新 prefill 的代价就被追平:约 46 分钟停顿。这就是你不该越过的线。
具体到 100k token 的 Anthropic 前缀(按标价约 $0.30 输入):
- 10 分钟停顿:两次 ping,$0.06,省掉 $0.38。保温,你领先 6 倍。
- 46 分钟停顿:十一次 ping,$0.33,对 $0.38 的重新 prefill。大致打平。这就是那条线。
- 1 小时停顿:十五次 ping,$0.45,去躲一次 $0.38 的重新 prefill。别 ping 了,让它冷掉,回来时付重新 prefill。
公式能告诉你自己的线在哪,只要代入你的价格和间隔。要点是:线是存在的,而且比大家以为的近得多。 越过之后,理性的做法就是停止为一个你永远不会兑现的保单付保费。
被所有人照抄的 30 秒惯例,其盈亏平衡只有约 6 分钟——这就是它在 10 分钟间隔上对四家提供商全都亏钱的原因。我也跑了 4 分钟那一组:ping 在 +240.1s 和 +480.1s 触发(漂移 0.1s),24 个样本中 23 个保持温热,同样热度下比 30 秒组便宜 7.8 倍。这个惯例不是谨慎,它只是贵。
600s 空闲,100k 前缀
| 让它死 | keepalive 30s | keepalive 240s | |
|---|---|---|---|
| Anthropic Sonnet 4.5 | $0.667(冷) | $0.867(亏钱) | $0.414(省 38%) |
| OpenAI GPT-5.1 | $0.115(本来通常就热) | $0.317(亏) | $0.136(亏) |
| DeepSeek V3.2 | $0.043(冷,TTFT 5.4s) | $0.249(亏) | $0.060(亏;但快约 3×) |
| Gemini 2.5 Pro | $0.131(本来通常就热) | $0.649(亏) | $0.186(亏) |
看最后一列。在 10 分钟停顿上,只有 Anthropic 和 DeepSeek 真的逐出了,所以只有它们有东西可保。即便在那里,30 秒惯例也是亏钱的。
这就是我最初发表的内容:在 10 分钟时,只有 Anthropic 真的省了。但那是关于「10 分钟」的事实,不是关于各提供商的事实。OpenAI 和 Gemini 在 10 分钟时还是热的,所以保温当然什么都没买到。真正的问题是:它们一旦逐出会怎样?
四、付费区间,实测
于是我在 30 分钟停顿上重跑了一遍——保留曲线说这个点上除 Gemini 外全部完全冷掉。现在所有家都有重新 prefill 可以避免了。同样的 4 分钟 keepalive,同样的 100k 前缀:
1800s 空闲,100k 前缀
| 让它死 | keepalive 240s | 结论 | |
|---|---|---|---|
| Anthropic Sonnet 4.5 | $0.333(冷,TTFT 2.9s) | $0.214 | 省 1.56× |
| OpenAI GPT-5.1 | $0.104(冷,TTFT 4.4s) | $0.085 | 省 1.23× |
| DeepSeek V3.2 | $0.022(冷,TTFT 5.4s) | $0.108 | 亏;只买到延迟 |
就是这样。一旦 OpenAI 真的逐出,它的 keepalive 也省钱。 Keepalive 从来不是 Anthropic 专属技巧。只要你的停顿长到触及逐出、又短到不超过盈亏平衡,它对任何提供商都划算。
每家都有这样一个区间:Anthropic 约 5 到 46 分钟;OpenAI 约 30 分钟到一小时以上(按它自己的最优间隔,见下一节)。区间之外,无论哪一侧,你都在为空气付保费。
DeepSeek 是真正的例外。 它确实会逐出,但一次冷的重新 prefill 只要两分钱,所以不管你怎么调时序,ping 的成本都高于它避免的那次逐出。它的 keepalive 只是延迟玩法:首 token 从 5.4 秒降到 2.0 秒。
Gemini 更糟:它从不可靠地逐出(命中率是路由抽奖,不是保留曲线),而且缓存读取是 0.25× 而非 0.1×,所以不存在任何一个停顿长度能让保温在成本上划算。对这两家,只有你在买速度时才保温,永远不是为了省钱。
五、超过 TTL,ping 会变成毒药
还剩一个问题。如果 keepalive 成本随间隔增长而下降,那为什么停在 4 分钟?于是我继续跑:同样的 30 分钟停顿、同样的前缀,ping 间隔取 4、8、15 分钟。
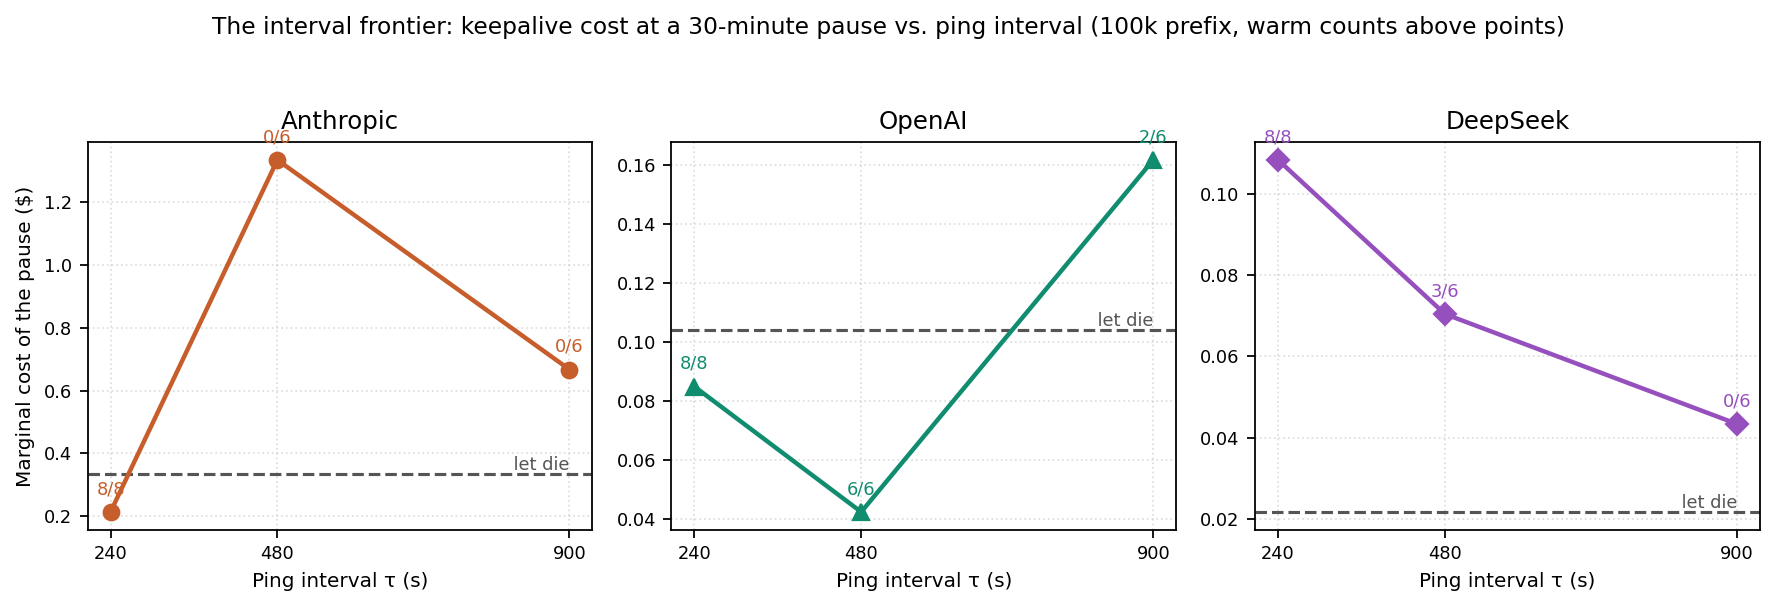
各 ping 间隔下停顿的边际成本,附命中计数。虚线:直接让缓存死掉。
间隔受提供商自身保留期约束,而这张图把线的两侧都画出来了。
- OpenAI 的缓存能扛住 8 分钟间隔,所以 8 分钟 ping 把成本再砍一半:$0.042 对 $0.104 的重新 prefill,2.45× 的节省,是 4 分钟 ping 的两倍。它真正的最优间隔约 8 分钟,不是 4。
- Anthropic 用 8 分钟 ping 是场灾难,原因很关键。它的缓存 5 分钟就死,所以每次 8 分钟 ping 都落在死缓存上,按全价写价重新 prefill。三次 ping、三次全量 prefill,而且你还只是靠时序巧合才温热着到达。账单:$1.334,是从不 ping 的 4 倍。超过 TTL 的间隔不只是浪费——每次 ping 都在付它本要避免的那笔罚金。
- 没有一家扛得住 15 分钟 ping,DeepSeek 在 8 分钟上是抛硬币(它的缓存约 9 分钟死)。
所以规则更锋利了:经济间隔 = 你自己测出来的该提供商保留期减去一个余量,而且逐家不同。 Anthropic 4 分钟,OpenAI 8 分钟。一个用单一全局 ping 间隔的多提供商 agent,要么在 OpenAI 上多付,要么在 Anthropic 上烧钱。
六、什么是确定的,什么是我相信的
确定:上面的算术、实测保留曲线、实测的 7.8×、盈亏平衡时间、以及带毒性边界的间隔前沿。这些你都可以拿公开的数据和测试装置去核。
相信:当所有人都采用这套建议之后会怎样。缓存层的逐出策略按「预期复用」排序;keepalive 人为制造了 recency,所以一旦所有客户端都 ping,LRU 就没什么可排序的了,整个层对所有人都退化。今天的驻留是按每次读取计价的,不是按 token-小时持有计价,所以每个运营者理性的「租金支付」都在给所有其他租户强加一笔未定价的成本。我的预测:keepalive 的普及会迫使提供商直接对驻留计量收费。 Google 的显式缓存已经按 token-小时计费,Anthropic 的 1 小时档以 2× 写入价也是同一方向的一步。套利是真实的,但它有到期日。
七、策略
- 只在有界的、大概率会被复用的停顿上保温(一次工具调用、一次审批等待),τ* 按提供商逐个设定为其实测保留期减去余量。Anthropic 约 4 分钟,OpenAI 8 分钟,Anthropic 的 1 小时档 50 分钟。
- 永远不要让 τ 超过提供商的保留期。 超过之后,每次 ping 都按全价重新 prefill 一个死缓存,keepalive 比什么都不做更贵(Anthropic 8 分钟 ping 时是 4 倍)。
- 超过盈亏平衡线就放弃 keepalive(Anthropic 价格下约 46 分钟)。让它死,重新 prefill,走人。
- 待在付费区间内。 只在停顿长于该提供商逐出点(Anthropic ~5 分钟、OpenAI ~30 分钟、DeepSeek ~10 分钟、Gemini 从不)且短于其盈亏平衡时保温。Anthropic 和 OpenAI 在区间内省钱;DeepSeek 和 Gemini 从不省成本,只省延迟。
- 低于逐出点就别费这劲。 缓存本来就还热着,ping 什么都没买到。这正是 30 秒惯例在每家上都犯的错。
- 永远不要给一个已死的会话保温。 pi agent harness 就是这么实现的:只在工具批次运行时 ping,默认关闭。
短暂地保温,按你自己提供商自己的节奏。少 ping,但永远别慢过缓存遗忘的速度。
八、2026 现状:今天实际怎么做
这一节是我加的,不是原文。
原文最有价值的东西是方法,不是数字。但它的结论全都绑死在具体数字上,而数字是这篇文章里最容易腐坏的部分——TTL 会调、价格会降、型号会换代。所以直接照抄「Anthropic 4 分钟、OpenAI 8 分钟」是最危险的读法:它正是原文第七节第一条所反对的(「按提供商逐个设定为其实测保留期」)。
1. 原文里的数字一个都不要直接抄
原文测的是 Anthropic Sonnet 4.5、OpenAI GPT-5.1、DeepSeek V3.2、Gemini 2.5 Pro,以及 Anthropic 的 5 分钟 TTL。这些是会变的:
- 价格是这篇文章里变动最快的东西。 原文的盈亏平衡(46 分钟 / 36 分钟 / 12 分钟)完全由「读价 ÷ 写价」这个比值决定。读价只要降一点,盈亏平衡线就大幅前移——上面那 46 分钟可能变成 20 分钟。用你今天的价目表重算这个比值,别用2026年7月的。
- TTL 是可配置的。 Anthropic 的 1 小时档(写入 2×)让最优间隔直接变成 50 分钟而不是 4 分钟。如果你的工作流停顿动辄半小时以上,选 1 小时档可能比 5 分钟档 + 4 分钟 ping 便宜得多——这是原文没有展开的一条岔路。
- 别信「20 分钟还有一半热」这种观测。 原文作者自己就踩了这个坑:他第一次只测到 10 分钟,误以为 OpenAI 不逐出。测到多长,决定你看到什么形状的曲线。 你的测试窗口必须显著长于你打算覆盖的最长停顿。
2. 你不需要他们的测试装置,你需要自己的
原文的成本模型其实就是一条公式,代入你自己的数就能算:
盈亏平衡空闲时长 ≈ τ × (w/r − 1)
  τ = 你的 ping 间隔
  w = 冷启动重新 prefill 的成本(含缓存写入费)
  r = 一次缓存读取的成本

保温是否划算:停顿 > 逐出点 且 停顿 < 盈亏平衡
最优间隔 τ*:你能采到的、最大的、仍然安全小于实测逐出点的值
落地只需三步:
- 量你自己的逐出点。 不需要 40 分钟 × 4 家的完整曲线,只需要:拿一段真实的前缀,间隔 30s 发一次请求、看
cache_read_input_tokens是否归零,把「开始归零」的那个时间点记下来。跑三五次取最小值。这一步是整件事里唯一非做不可的,成本大约几美元。 - 代入公式算 τ* 和盈亏平衡。 用你当前的实际单价。
- 把你的停顿分布打出来。 如果你的 agent 停顿 95% 落在这条带子之外,那这个优化对你根本不重要——先去看别的地方。
3. 今天更省事的做法
- 能不等就别等。 Keepalive 治的是「停顿」,而停顿经常是可以消除的:把人类审批异步化、把长构建挪到缓存窗口之外、把一个长会话拆成两个短会话。结构性消除停顿永远优于花钱维持缓存。 原文整个讨论的前提是停顿不可避免,但这个前提值得先质疑一次。
- 优先用长 TTL 档位,而不是高频 ping。 高频 ping 是在每次读取上付费;长 TTL 是在一次写入上付费。对可预测的长停顿,长 TTL 通常更便宜也更简单(少一个后台定时器、少一堆并发请求)。原文的「Anthropic 1 小时档 → 50 分钟」正是这个方向。
- 批处理窗口天然免疫这个问题。 如果你的负载能容忍异步(比如夜间批处理),直接用 Batch API,它自带更低的单价,把 keepalive 的整套算计直接消掉。
- 要监控,不要设完就不管。 至少记三个量:ping 次数、缓存命中率、每会话成本。失效模式是静默的:间隔一旦越过 TTL,账单会涨到 4 倍,而你的日志里只会显示「keepalive 正常运行」。给「ping 后命中率没有回升」加一条告警。
- 多提供商路由会让单一全局间隔失效。 原文的结论很明确:一个全局间隔必然在某一头上亏钱。只要你走网关/路由器(LiteLLM、OpenRouter 之类),要么按上游分别设间隔,要么干脆关掉 keepalive 只保留长 TTL。
4. 心理上最该带走的一条
原文真正反直觉、也最耐用的结论不是「4 分钟」,而是:这类优化存在一条线,而线比直觉近得多。
30 秒这个「保守」设置看着稳妥,实际是每周都在为一份永远不会理赔的保险付保费;而越过 TTL 之后,「保守」会直接变成 4 倍的账单。这两种错误的方向相反,成因相同:没有测量,只是跟随惯例。换掉模型、换掉价格、换掉 TTL 档位,那条线都会移动——量一下,是唯一不会过时的做法。
附:参考
- Shubham Tiwari, Tapan Chugh, Nash Rickert, Simon Peter, Ratul Mahajan, Haiying Shen. CacheWise: Understanding Workloads and Optimizing KVCache Management for Efficiently Serving LLM Coding Agents(启发本项目的演讲)
- Maxim Khailo. Keeping the Cache Warm Pays: Keepalive Economics for Agentic Workloads(arXiv:2607.19214)及测试装置 + 数据(
scripts/cache-research) - Aider AI. Change history(cache keepalive, v0.53.0, 2024)
- Anthropic. Prompt caching(pre-warming 指引)
- Veritas Supera. We Taught Our AI Agents to Take Coffee Breaks(纸面上的 4 分钟间隔)
- Brandon Wie. Anthropic Prompt Cache TTL + Cost Mechanics
- OpenClaw. Cache keep-warm pings proposal(TTL 成比例的间隔)
- Don’t Break the Cache(该缓存什么,另一个问题)
- Prompt cache thrashing(公地外部性)