
转载与翻译声明
本文译自 Quanta Magazine 的文章 How Can AI ID a Cat? An Illustrated Guide.
- 原文标题:How Can AI ID a Cat? An Illustrated Guide.
- 作者:Ben Brubaker(Staff Writer)、Mark Belan(Graphics Editor)
- 原文出处:quantamagazine.org
- 原文发布时间:2025-04-30;本译文发布:2026-10-12
- 翻译说明:原文版权归 Quanta Magazine 所有,插画由 Mark Belan 绘制。本文为完整中文翻译,原文的 12 个 Lottie 动画与 12 张静态插图均按原位置还原,仅供学习交流;如版权方有异议将立即删除。
文末我加了一节 【2025 之后:这份图解在今天仍然成立吗】,补上原文写作时来不及覆盖的东西。批注是我的,不代表原作者观点。
James O’Brien 为 Quanta Magazine 绘制
看一眼猫的照片,你会立刻认出那是猫。但让计算机去识别猫的照片,你很快就会发现这事一点也不直接。你需要写代码,去捕捉无数张猫照里那个共通的特质——而这些照片背景各异、拍摄角度也各不相同。你甚至不知道该从哪里下手。
如今计算机能轻松识别猫的照片,但这并不是因为有哪个聪明的程序员找到了提取「猫之为猫」之本质的方法。它们用的是神经网络:一类通过观察数百万乃至数十亿个样本学会识别图像的人工智能模型。神经网络还能以惊人的流畅度生成文本、精通复杂游戏、解决数学和生物学问题——而这一切都没有任何明确的指令。
关于神经网络内部到底在做什么,研究者还有很多不清楚的地方。但它们并非完全不可揣度。把神经网络拆解成最基本的构件,我们就能看清它是怎么学会区分一只虎斑猫和一块桌布的。
一个简单的分类器
猫的识别,属于研究者所说的分类任务。给定一个对象——在这里是一张图片——目标是把它归到正确的类别里。有些分类任务比区分「猫」和「不是猫」简单得多。我们来看一个虚构的例子,涉及两个虚构的地区:三角领地(Triangle Territory)和方形州(Square State)。
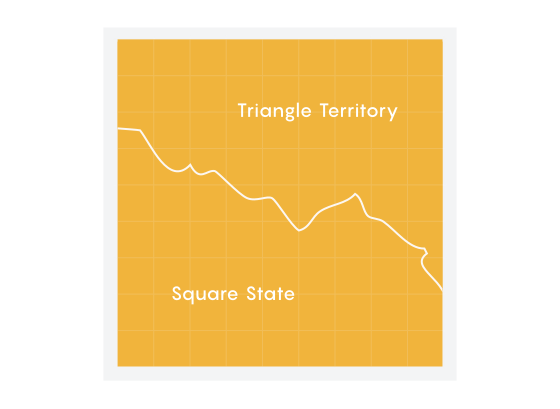
你拿到一个新点,已知它的经度和纬度,要判断这个点落在哪个区域内。但你手上没有一张标出边界的地图,只有两个区域内的一些已知点。
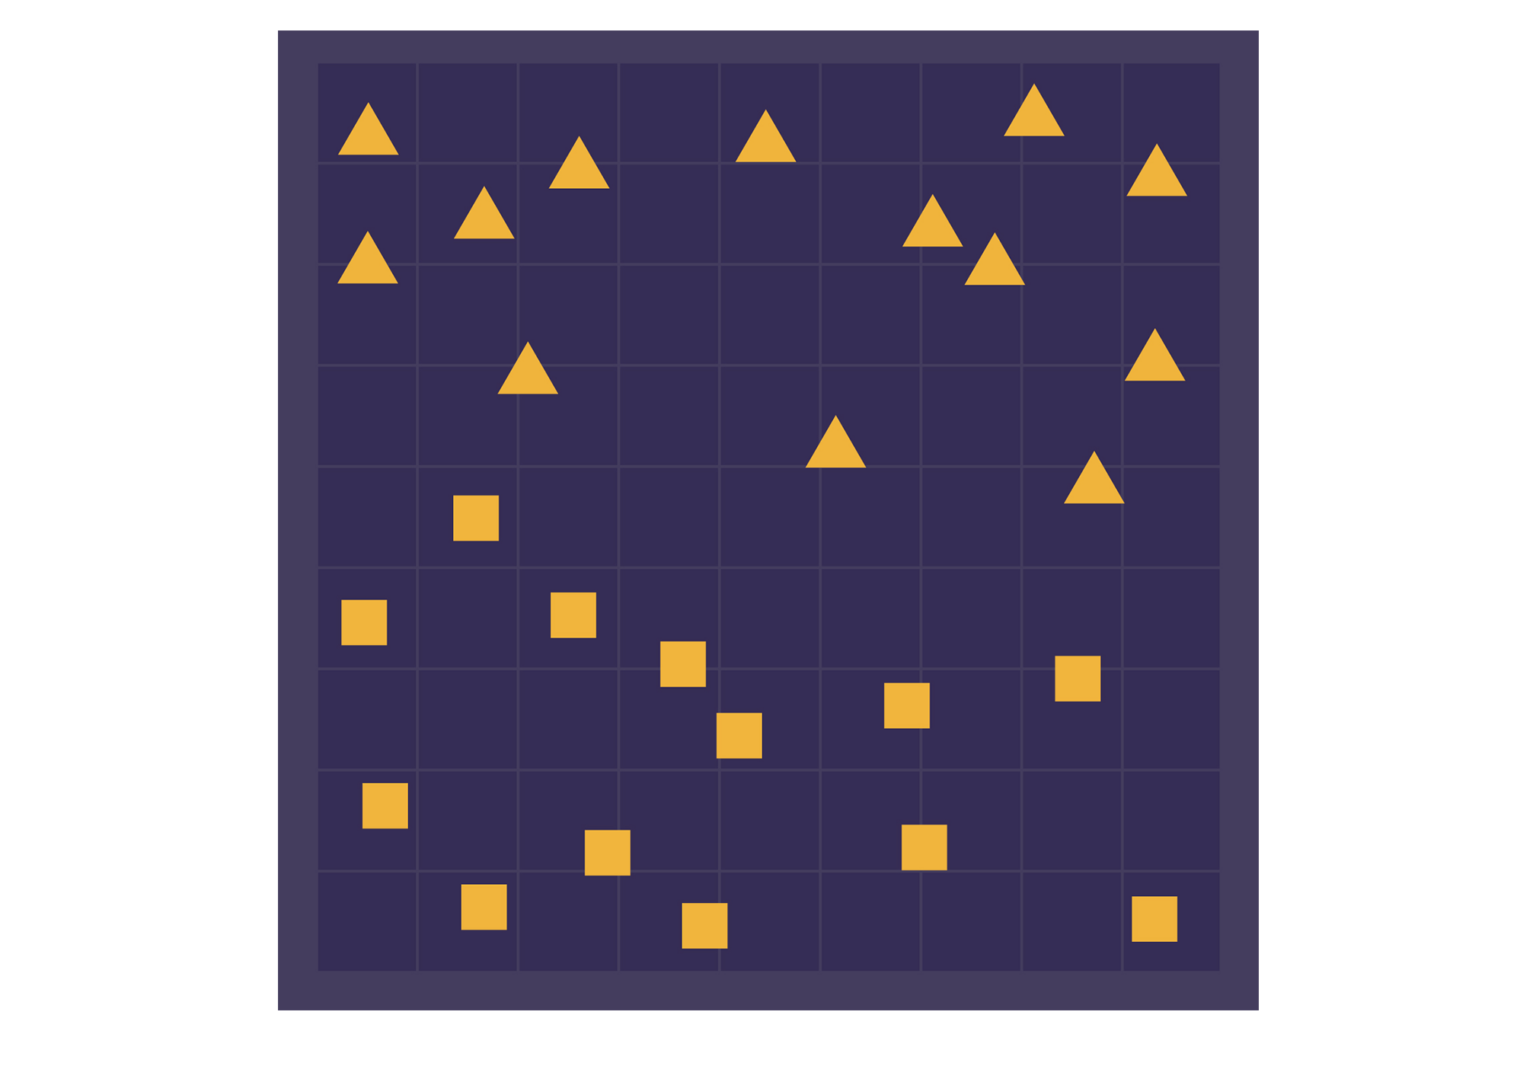
要搭一个能自动给未知点归类的「分类器」系统,你需要画出一条边界。有了边界之后,再给一个新点,分类器只需要看它在边界的哪一侧。
但你怎么决定边界该画在哪里?这正是神经网络登场的地方。它会根据最初那组已知数据点,找出最有可能的那条边界。
在理解这个过程之前,我们得先把地图放一边,来看看神经网络的基本构件——神经元。一个神经元就是一个数学函数,有若干输入、一个输出。喂进去一些数字,它会吐出另一个数字。就这样。
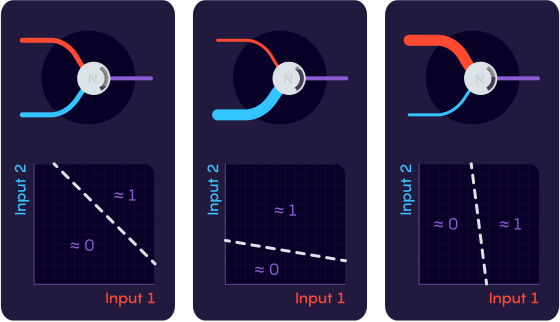
再简单一点说:输出几乎总是要么接近 0,要么接近 1。到底会是哪个?这取决于输入,也取决于另一组数字,叫做参数。一个有两个输入的神经元有三个参数。其中两个叫权重,决定每个输入对输出的影响有多大。第三个参数叫偏置,决定这个神经元整体上更倾向于输出 0 还是 1。
现在我们来看看输入和输出的关系。下面三张图展示了三组不同参数下的神经元。在每一种情况下,随着输入变化,都会穿过一条边界,在那里神经元的输出从 0 迅速升到 1。在这些图上,这条边界永远是一条直线。参数决定了这条线的位置和角度。
要造出一个能告诉我们新点该归方形州还是三角领地的分类器,我们就得调整这条线,让它尽可能准确地代表两个区域之间的边界。这里我们约定:输出接近 0 就算在方形州,接近 1 就算在三角领地。
调整这条线,就是通过一个叫训练的过程去调整神经元的参数。第一步是把参数设成随机值,也就是说神经元最初的边界线跟真正的边界毫无相似之处。
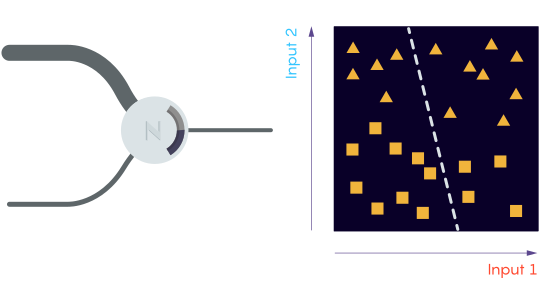
训练时,我们把每个已知数据点的经纬度喂进神经元的输入。神经元会根据当前参数吐出一个输出,然后把这个输出和真实值比较。有时候它答对了。
有些点则会被分错。
每当神经元答错,一个自动化算法就会把神经元的参数稍微拨动一下,方向是让边界朝那个分错的点靠过去。
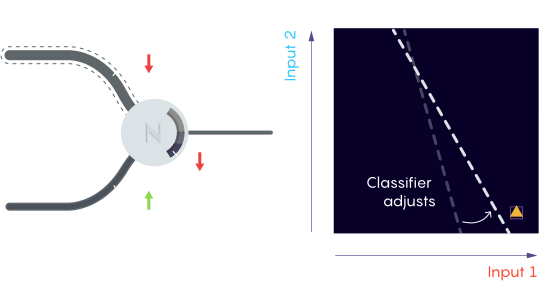
算法在训练数据上反复跑这个过程。最终我们会得到一组参数值,对应的那条直线,最好地近似了边界的真实形状。
最后,我们就可以把这个分类器用在没参与过训练的新数据上了。它并不完美,但大多数时候能给出正确答案。
一张神经元组成的网
对我们的简单例子来说,单个神经元已经够用了——但这只是因为三角领地和方形州之间的真实边界本来就接近一条直线。面对更困难的任务,我们需要用大量互相连接的神经元——也就是神经网络。和单个神经元一样,一张网络也只是一个数学函数。数字进去,别的数字出来。
神经网络里的神经元按组排列,这些组叫做层。
一层里可以有任意多个神经元,一张网络也可以有任意多层。每一层神经元的输出,会成为下一层神经元的输入。
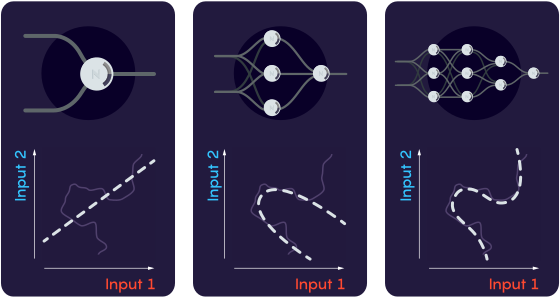
大的网络有很多参数:每个神经元一个偏置,神经元之间的每一条连接一个权重。这些额外的参数让网络能够找出更复杂的边界。
举个例子:假设你在做同样的地图分类任务,但真实边界离一条直线很远。
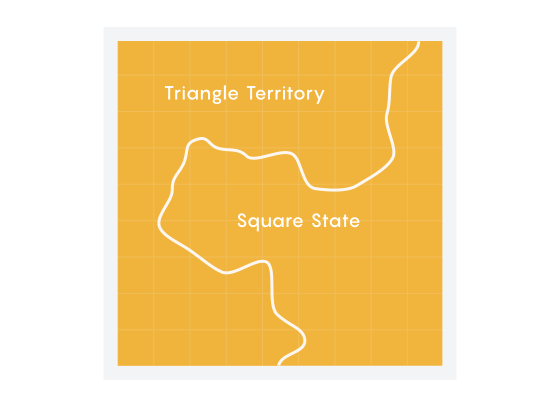
我们可以试着训练一个单神经元分类器去逼近这条边界,但它永远不会表现得多好。一般来说,更大的网络能做更复杂的工作,尽管它们也需要更多的训练数据。
从地图到猫
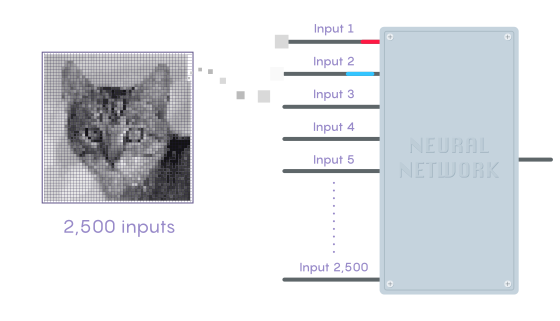
我们已经看到,用更多神经元可以让神经网络更有能力。但到目前为止,我们看的网络都只有两个输入。神经网络的输入数量没有上限,而大多数有用的任务都需要很多个输入。
在前面的例子里,神经元的两个输入是地图上点的经度和纬度。神经网络的输入数字也可以表示其他类型的数据。比如,一个 0 到 1 之间的数,可以代表单个像素的灰度值。
这意味着任意一对像素都可以画成二维空间里的一个点。
同样,像素三元组对应三维空间里的点。
更多像素需要更多维度。我们无法想象三维以上的东西,但研究者已经发展出了一些方法来观察这些抽象空间的三维表示——就像用一个二维快照去看一个三维空间。用九个维度,我们可以表示一个三乘三网格上的不同图案。
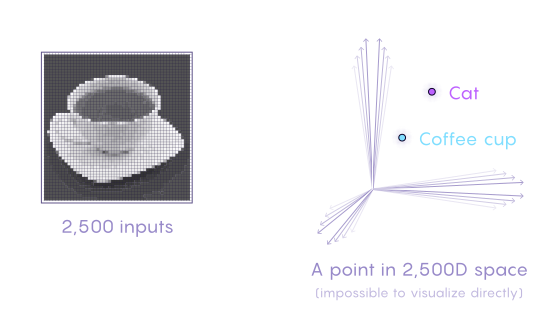
要看清这有什么用,让我们从九个输入一跃到 2500 个,代表一个 50×50 的像素网格。这个尺寸的网格上的不同图案,可以描绘有意义的图像,比如猫的照片。每一张猫的照片,都对应 2500 维空间里的一个不同的点。
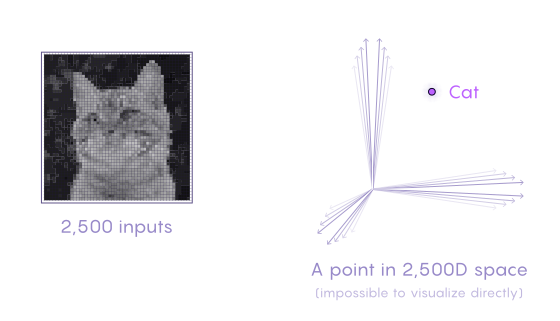
这个空间里其他的点,则对应咖啡杯的照片。
给定足够多的数据点,我们就能训练一个大型网络来区分「猫」和「非猫」。
所有猫的照片都落在 2500 维空间里某个形状复杂的区域中。训练算法会反复拨动网络的参数,直到找出圈住这个无法想象其形状的区域的边界。
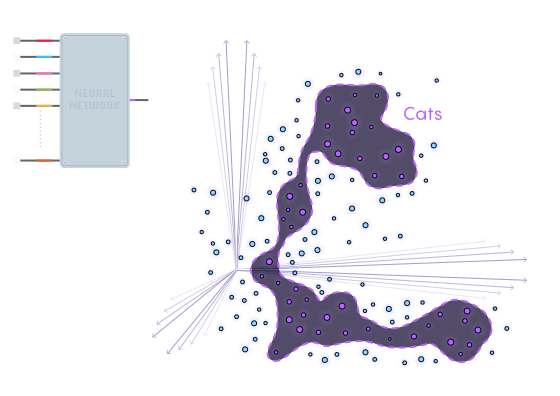
训练完成的网络,就能正确分类那些不在训练数据里的新图片了。瞧——我们造出了一个能「认出」猫的图片的网络。
不止是猫
我们的猫检测网络有很多神经元、很多输入,但只有一个输出。如果有更多输出,我们就能训练网络识别很多类物体,而不只是猫。每一类都对应 2500 维空间里的一个不同区域。更复杂的图像识别网络,已经用在了天体物理、细胞生物学、医学和许多其他领域。
神经网络还能做分类之外的任务。像 ChatGPT 这样的大语言模型,其底层的神经网络中,输入和输出的数字代表的是词。最先进的网络非常庞大,有数十亿甚至数万亿个参数。这让人很难确切知道网络的不同部分各自在干什么。弄清楚大型神经网络里到底发生了什么,是今天许多研究者正在攻克的难题。
【2025 之后:这份图解在今天仍然成立吗】
这一节是我加的,不是原文。
原文写于 2025 年 4 月,定位是入门图解,讲的是神经网络最基本的机制。这类内容不会因为模型换代而过时——它讲的数学没变。但有两点值得补上。
一、它刻意省略了什么
原文为了讲清楚「几何直觉」,做了一些简化。这些简化在入门层面是对的,但你往下走的时候会撞上它们:
① 神经元的输出不只有 0 和 1。 原文说「输出几乎总是要么接近 0,要么接近 1」,这是在描述分类任务的最后一层。中间层的神经元用的是 ReLU、GELU 之类的激活函数,输出可以是任意实数。把「神经元就是输出 0 或 1」当成通则,看真实网络时会困惑。
② 单层网络的边界确实是直线,多层不是。 原文说「在这些图上,边界永远是一条直线」——这句话限定在单个神经元上。一旦叠成多层,边界就可以是任意复杂的曲面。原文后面用「更大网络能找到更复杂边界」带过,但没有说清楚为什么:层叠之所以有效,是因为每一层都在对前一层做换坐标系,把原本纠缠在一起的数据点重新摆开,让它在新坐标系里变得线性可分。这是「深」的意义所在,也是原文最值得展开却没展开的一点。
③ 那 2500 维空间里的「区域」到底是什么形状,没人知道。 原文说训练算法「找出圈住这个无法想象其形状的区域的边界」,措辞很诚实。但要补一句:我们其实不知道那是怎样一个区域。高维空间的反直觉之处在于,它的体积绝大部分集中在「壳」上,而「猫的区域」可能是一堆互不相连的碎片,而不是一个规整的团块。这直接影响泛化行为。
④ 原文没有提到「为什么能泛化」。 训练只是在已知点上调参数,凭什么在新图片上管用?原文默认了这一点。这是个真问题,到今天也没有完全解决——但现在有一些经验性的答案(数据分布本身的低维结构、隐式正则化、网络的归纳偏置),值得单独看。
二、2025 年之后新增的、值得知道的
① 图像这条线,主干已经从「分类网络」转向「多模态模型」。 原文最后一段提到 ChatGPT 用的是把词表示为数字的网络。2025 年之后,图像和文本已经并进同一个表示空间——CLIP 这类对比学习模型让「一张猫的图」和「文字『一只猫』」落在相近的位置。这正好是原文那套几何直觉的自然延伸:不再是给「猫的区域」画边界,而是让不同模态在同一空间里对齐。
② 「理解大网络内部在做什么」这件事,有了专门的学科。 原文结尾说这是个「占据许多研究者的难题」。现在这块叫 可解释性(interpretability),而且已经分化出两条路线:一是机制可解释性(把网络拆成人看得懂的电路),二是探针与表征分析(看某一层编码了什么信息)。如果你对原文那种「拆开看里面」的精神感兴趣,这是直接的后续。
③ 原文的几何视角在今天的实践里仍然好用,但要配合一个修正。 现代网络(尤其是 Transformer)的表示空间维度远高于 2500——常见是几千到上万维。这个尺度下,原文那种「找一个区域把它圈起来」的直觉会失效,实践中更常用的是余弦相似度 / 内积这类度量,而不是几何上的「内外」。「高维空间里的距离和方向不是一回事」,是继续往下走时必须换掉的一个直觉。
三、一句话总结
这份图解讲的是不变的部分——神经元、参数、训练、用维度换表达能力。这些概念从 1958 年的感知机到今天的 Transformer 一脉相承,学一次可以一直用。
它省略的,主要是**「深」为什么有用**、以及高维几何的诡异之处。这两块恰恰是入门之后最先撞上的墙,也是我建议你接下来补的。
附:关于本文的插图
原文的插图不是静态图片——其中 12 张是 Lottie 矢量动画(.json 格式,由 lottie-web 播放),另外 12 张是静态 SVG。两部分我都按原位置还原了。
两个实现上的细节:
- 动画里的标签保留了英文(
Input 1、Weight 2、Bias等)。Lottie 的文本用的是导出时烘焙进文件的字符集,不含汉字——我试过替换,汉字会直接渲染不出来。这些词在正文里都有对应解释,保留原文既不损失信息,也避免破坏插画本身的排版。 - 原站每张插图都有桌面版和移动版两套(靠
.hide--xs之类的 class 切换),内容相同、构图不同。我只取了桌面版,窄屏下由 CSS 缩放。
顺带一提:4_Parameters-Changing.json 里原本引用了一张位图,但那个 URL 在原站也是 404——lottie-web 加载失败会静默降级,所以原站那张动画一直缺一块,没人察觉。我这边把这条死引用摘掉了,视觉结果和原站一致,但不再产生控制台报错。
附:参考资料
- Ben Brubaker, Mark Belan. How Can AI ID a Cat? An Illustrated Guide. Quanta Magazine, 2025-04-30. 原文
- Quanta Magazine. Science, Promise and Peril in the Age of AI(系列)