
Java 学习笔记
一、Redis
1.1 缓存穿透
场景:查询一个根本不存在的数据,缓存和数据库中都没有。
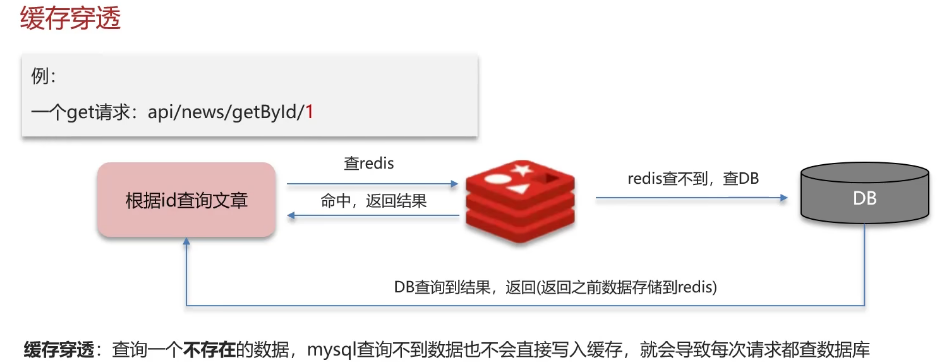
问题:每次请求都会绕过缓存,直接打到数据库。
| 方案 | 原理 |
|---|---|
| 缓存空值 | 将 null 也写入缓存,设置较短过期时间 |
| 布隆过滤器 | 利用 Hash 函数 + 二进制位数组,快速判断数据是否存在 |
1.2 缓存击穿
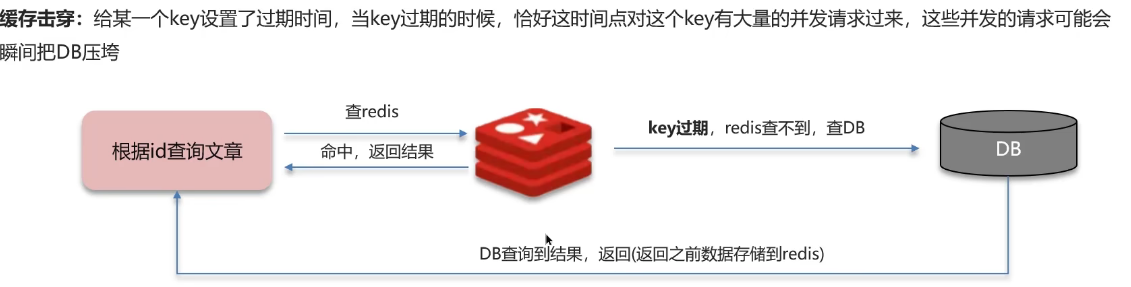
场景:热点 key 过期瞬间,大量并发请求同时涌入数据库。
| 方案 | 原理 | 特点 |
|---|---|---|
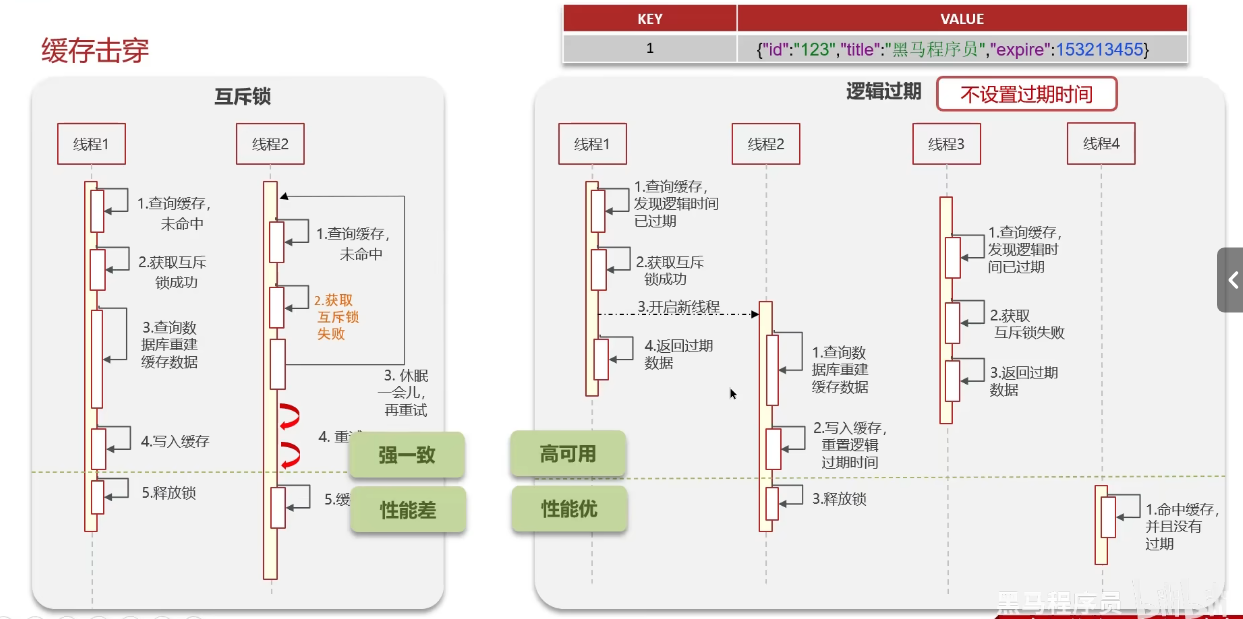
| 互斥锁 | 只让一个线程查库回写缓存,其余阻塞等待 | 强一致性,性能较差 |
| 逻辑过期 | 不立即删除,先返回旧数据,异步更新缓存 | 高可用,性能好 |
1.3 缓存雪崩
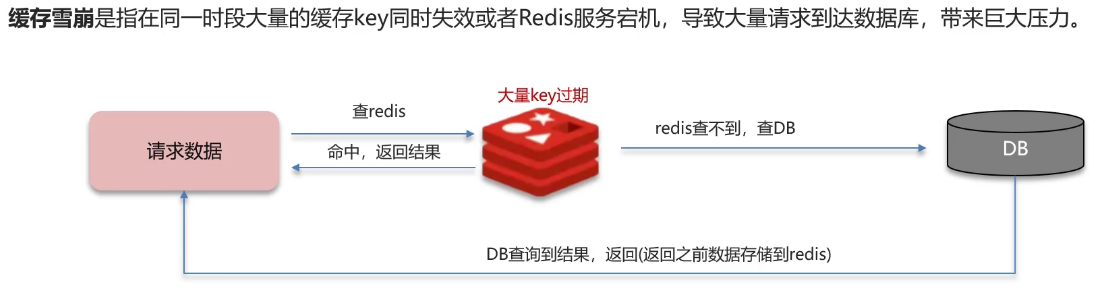
场景:同一时段大量 key 同时过期,或 Redis 宕机,请求全部打到数据库。
解决方案:
- TTL 加随机值 — 避免大量 key 同时过期
- Redis 集群部署 — 提高可用性和分区容错性
- 限流降级策略 — 业务层添加多层防护
- 多级缓存 — 引入本地缓存(如 Caffeine)作为前置缓冲
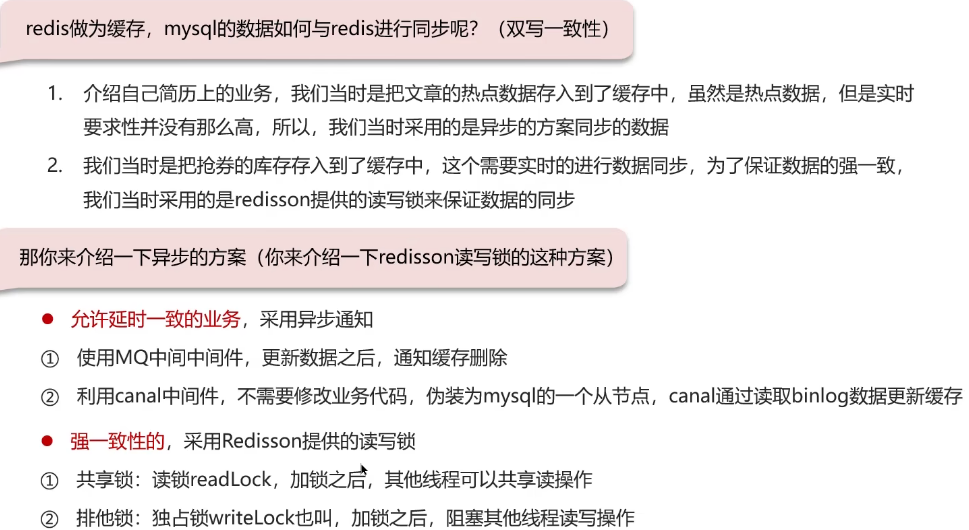
1.4 双写一致性
核心问题:修改数据库的同时,如何保证缓存与数据库的数据一致?
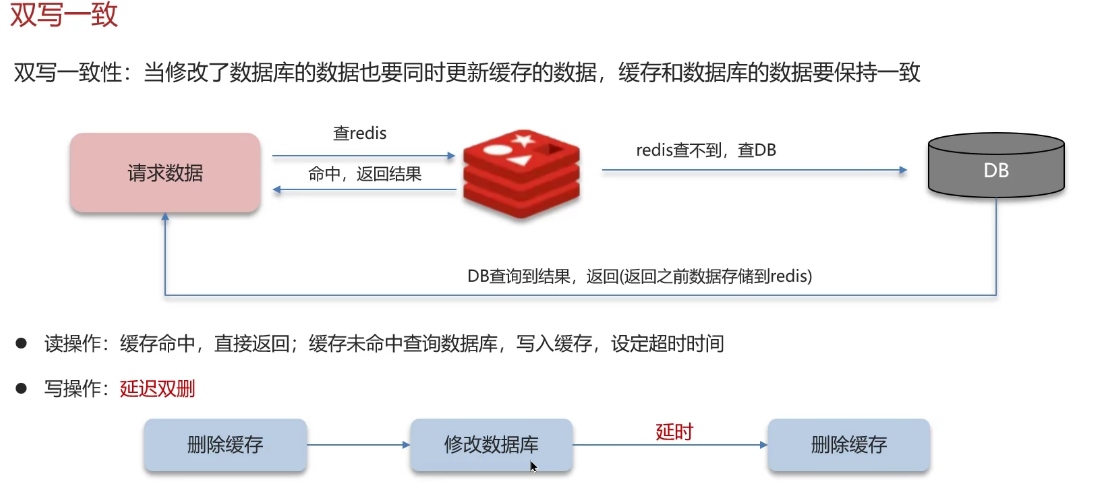
方案一:先删缓存,再操作数据库
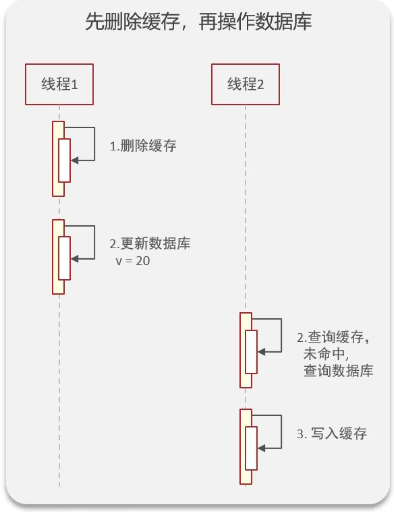
正常流程:删除缓存 → 更新数据库 → 查询数据库 → 更新缓存
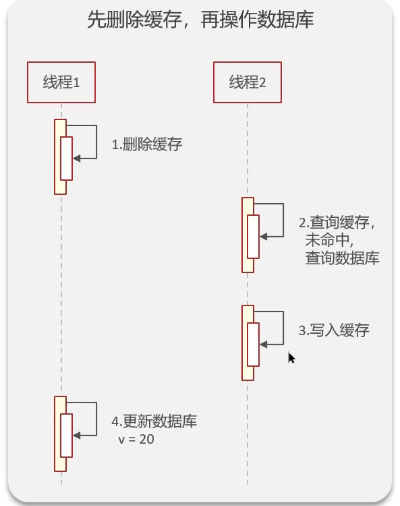
异常情况:删除缓存 → 查询数据库(旧值)→ 写入缓存(旧值)→ 更新数据库 → 缓存中仍是旧数据!
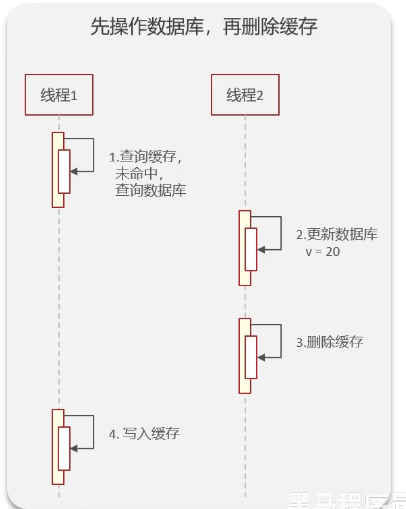
方案二:先操作数据库,再删除缓存
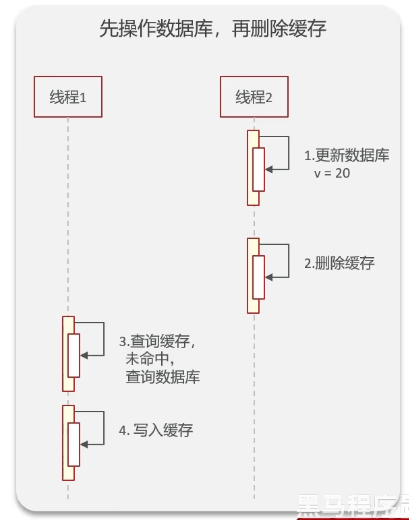
正常流程:更新数据库 → 删除缓存 → 查询缓存(未命中)→ 查库 → 写入缓存
解决方案总结
| 方案 | 原理 | 适用场景 |
|---|---|---|
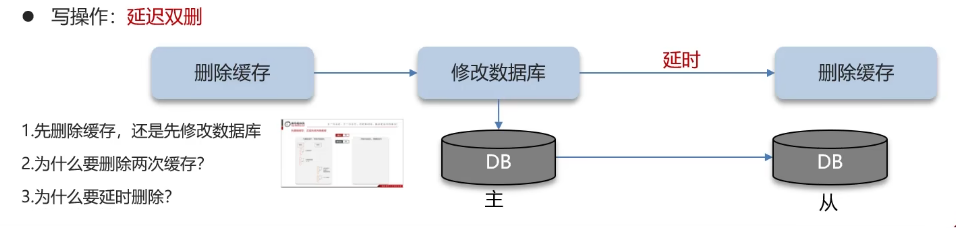
| 延时双删 | 删缓存 → 更新库 → 等一会 → 再删缓存 | 兜底策略,轻量级 |
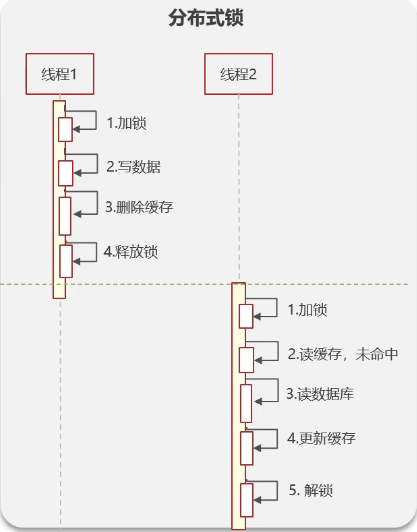
| 分布式锁(读写锁) | 写时加排他锁,读时加共享锁 | 强一致性要求 |
| 异步通知(MQ / Canal) | 更新后异步通知缓存更新/删除 | 允许短暂延迟 |
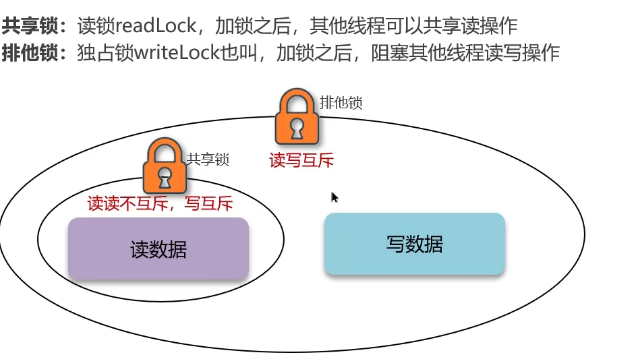
- 共享锁:加锁后其他线程可共享读操作
- 排他锁:加锁后阻塞其他线程的读写操作
1.5 持久化(RDB / AOF)
RDB(Redis Database Backup)
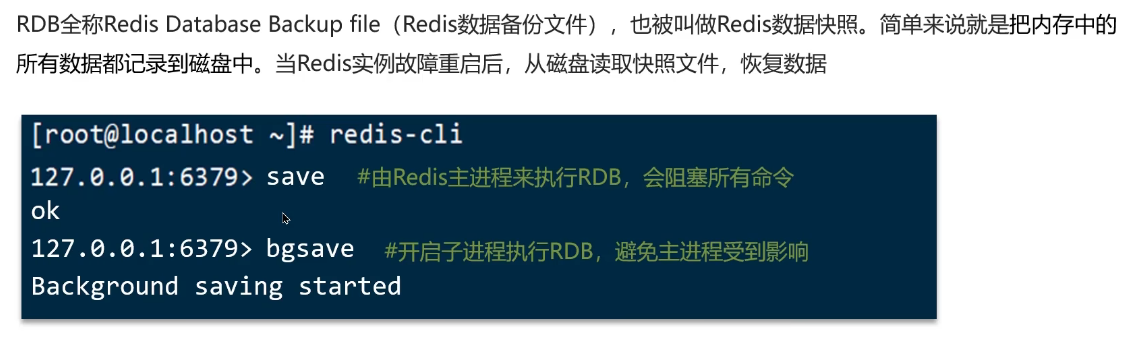
执行原理:
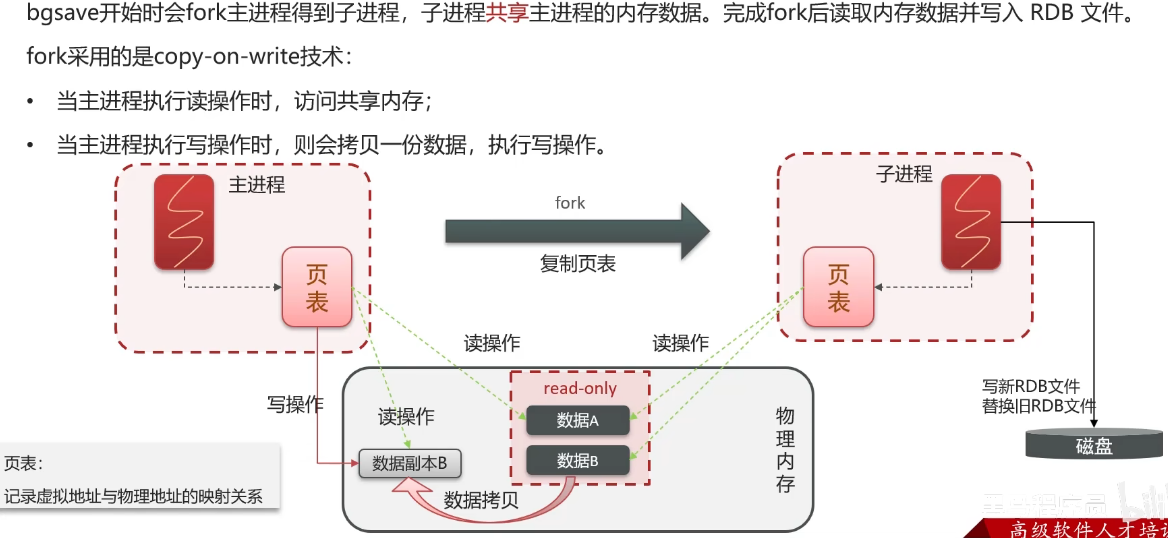
利用页表映射关系 + Copy-on-Write 技术:
- 主进程读操作 → 直接访问共享内存
- 主进程写操作 → 拷贝一份数据,在新副本上执行
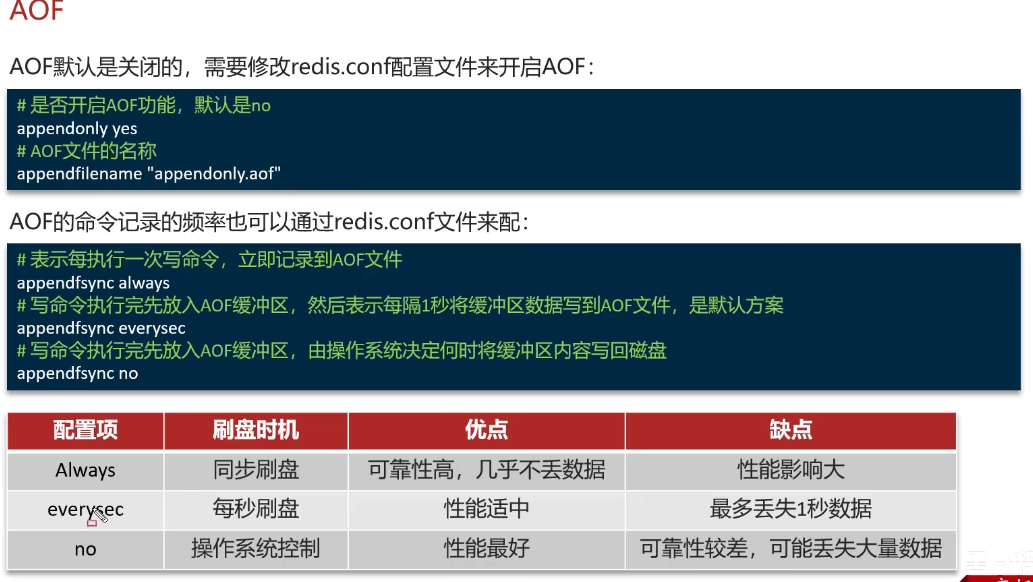
AOF(Append Only File)
核心思路:把每一条写命令追加记录到日志文件中,重启时重新执行这些命令来恢复数据。
AOF 重写机制:
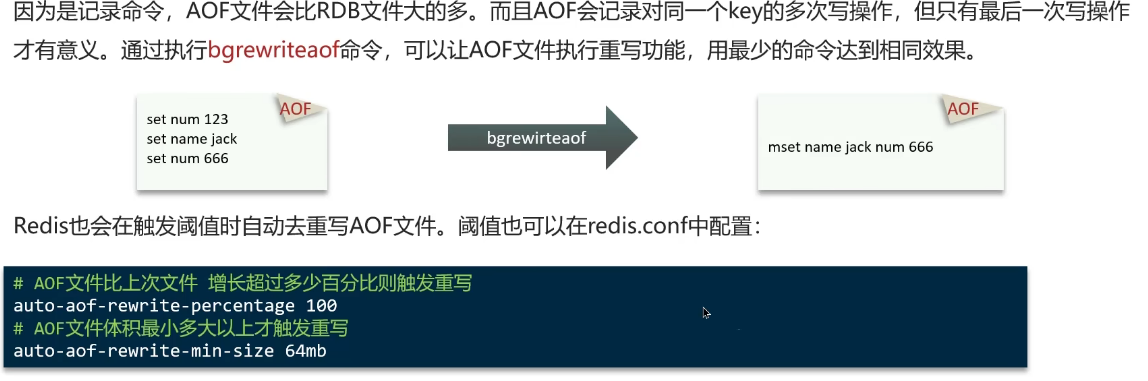
用最少的命令达到相同的数据恢复效果,大幅压缩文件体积。
RDB vs AOF 对比
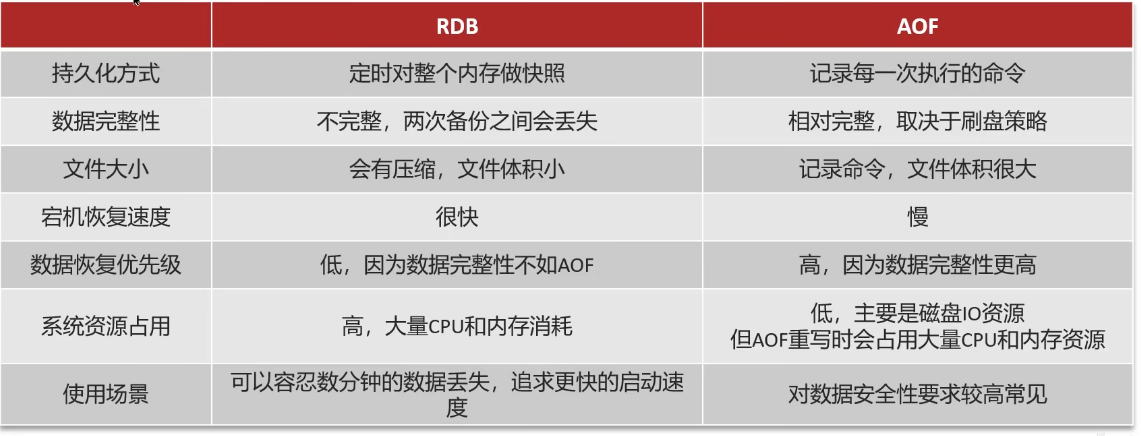
| 维度 | RDB | AOF |
|---|---|---|
| 文件大小 | 小 | 大 |
| 恢复速度 | 快 | 慢 |
| 数据安全性 | 可能丢失最后一次快照后的数据 | 更高 |
| 默认开启 | 是 | 否 |
1.6 删除策略与淘汰策略
删除策略(Key 过期后如何删除)
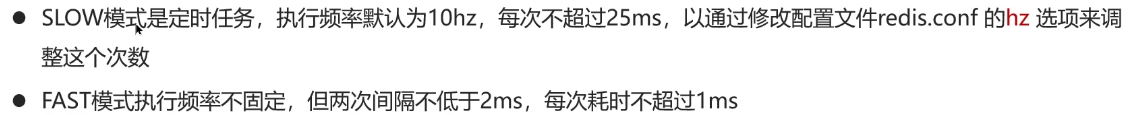
惰性删除:访问 key 时检查,过期则删除。

定期删除:每隔一段时间随机抽取 key 检查,过期则删除。
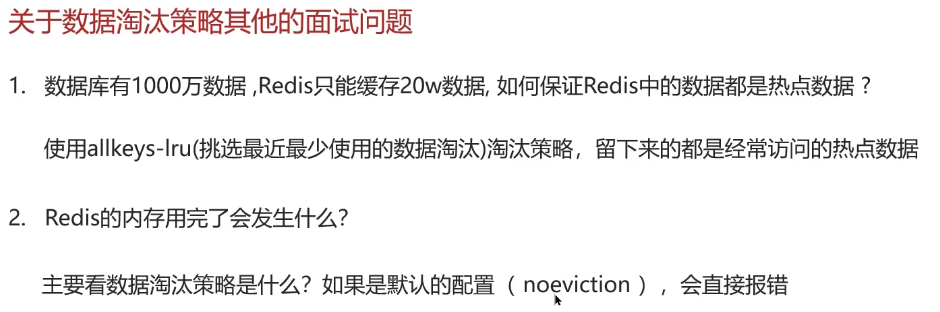
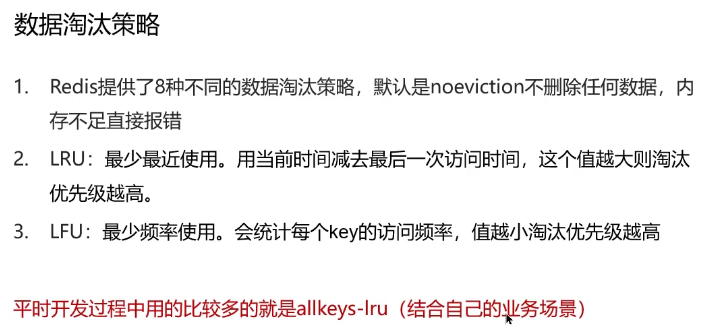
数据淘汰策略(内存满了怎么办)
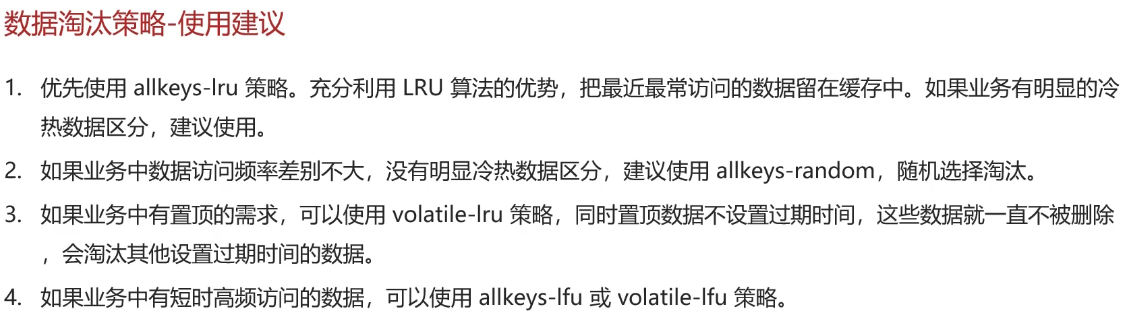
| 策略 | 范围 | 说明 |
|---|---|---|
noeviction | — | 默认。不淘汰,内存满后不允许写入 |
volatile-ttl | 有 TTL 的 key | TTL 越小越先淘汰 |
allkeys-random | 全体 key | 随机淘汰 |
allkeys-lru | 全体 key | LRU 算法淘汰 |
allkeys-lfu | 全体 key | LFU 算法淘汰 |
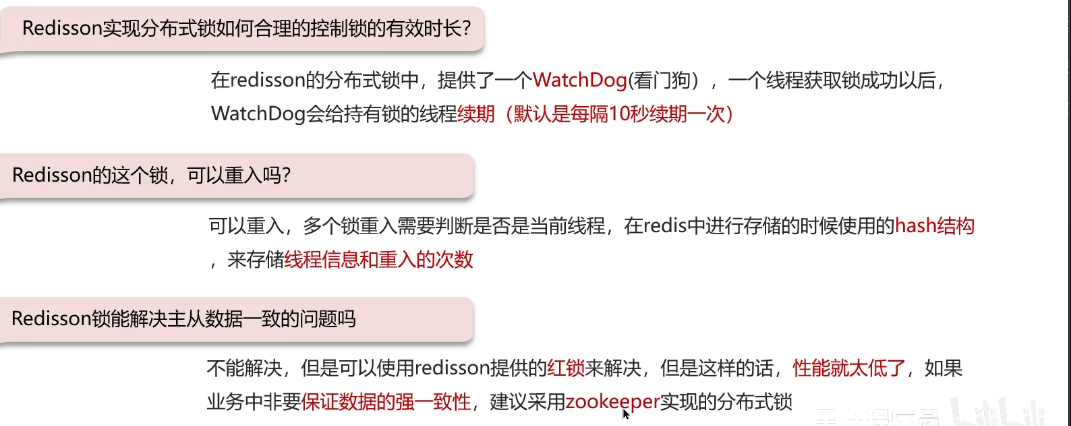
1.7 Redis 分布式锁
场景:服务集群部署下,普通的 JVM 锁无法跨节点互斥。
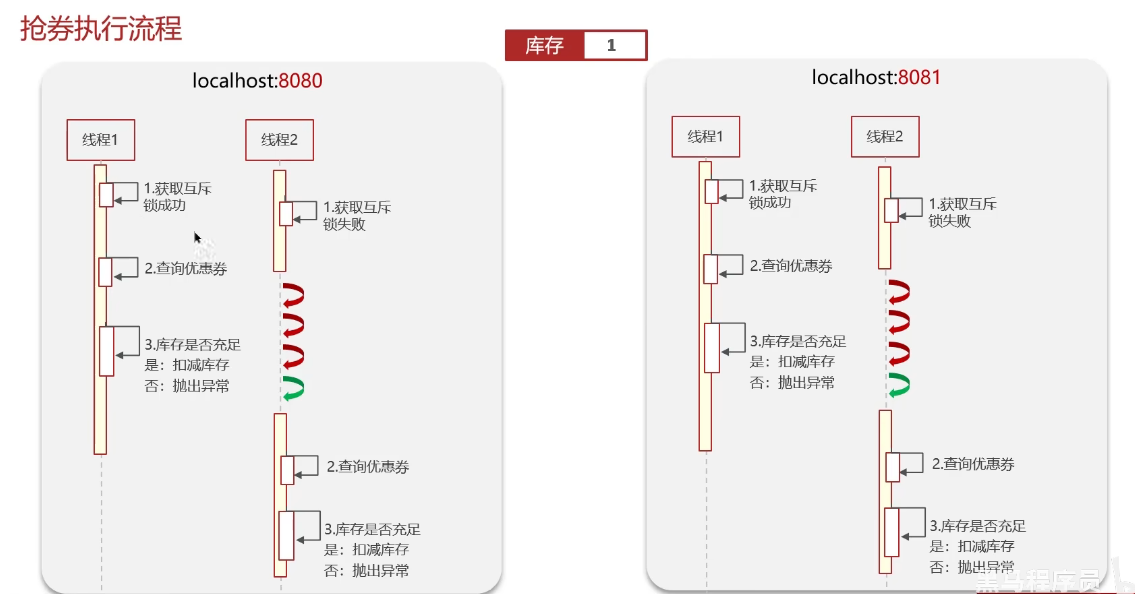
SETNX 原理
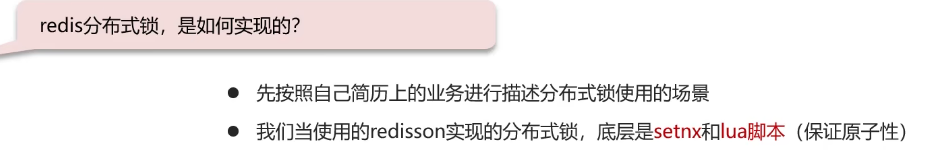
核心命令:SETNX(SET if Not eXists)。利用 Redis 单线程特性,只有一个客户端能成功设置 key。
Redisson 实现
public void redisLock() throws InterruptedException {
    RLock lock = redissonClient.getLock("heimalock");
    boolean isLock = lock.tryLock(10, TimeUnit.SECONDS);
    if (isLock) {
        try {
            System.out.println("执行业务");
        } finally {
            lock.unlock();
        }
    } else {
        System.out.println("获取锁失败,请稍后重试");
    }
}
1.8 Redis 集群
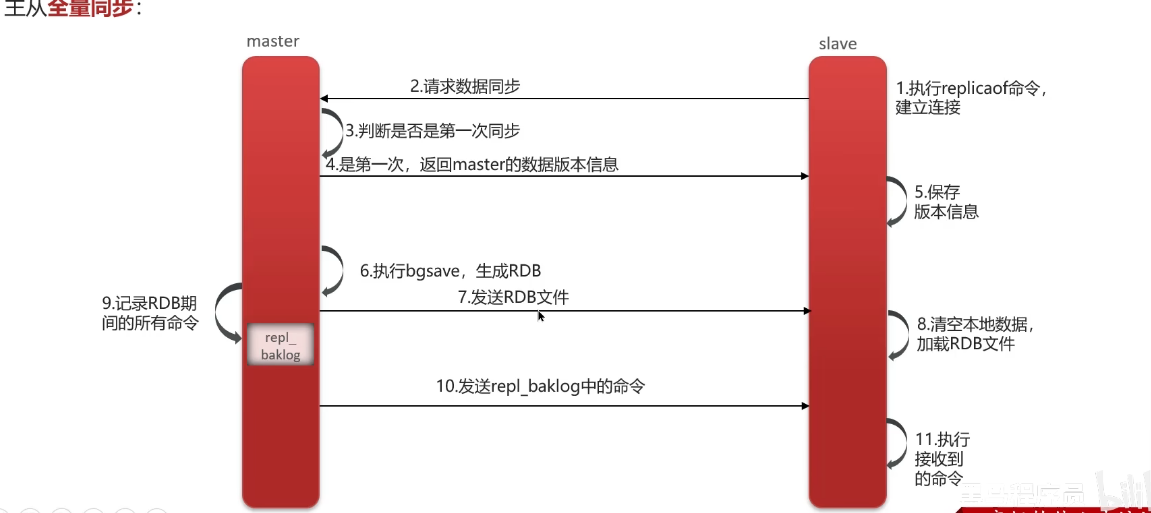
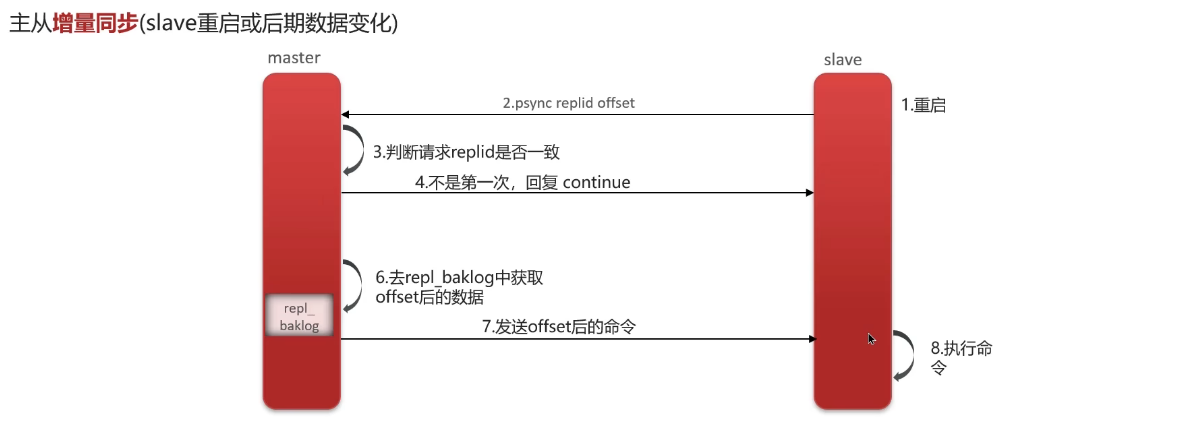
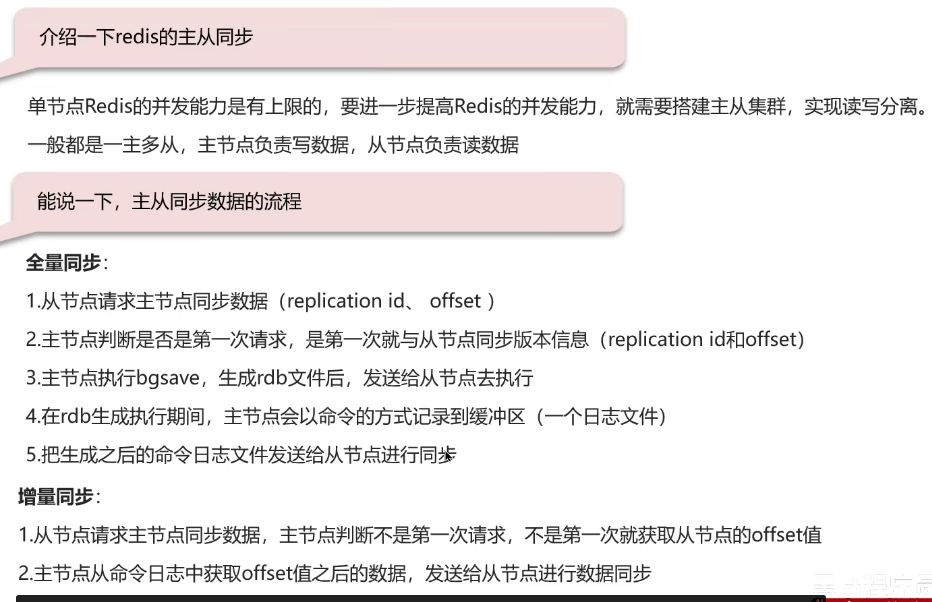
主从复制
主从全量同步:
主从增量同步:
哨兵机制
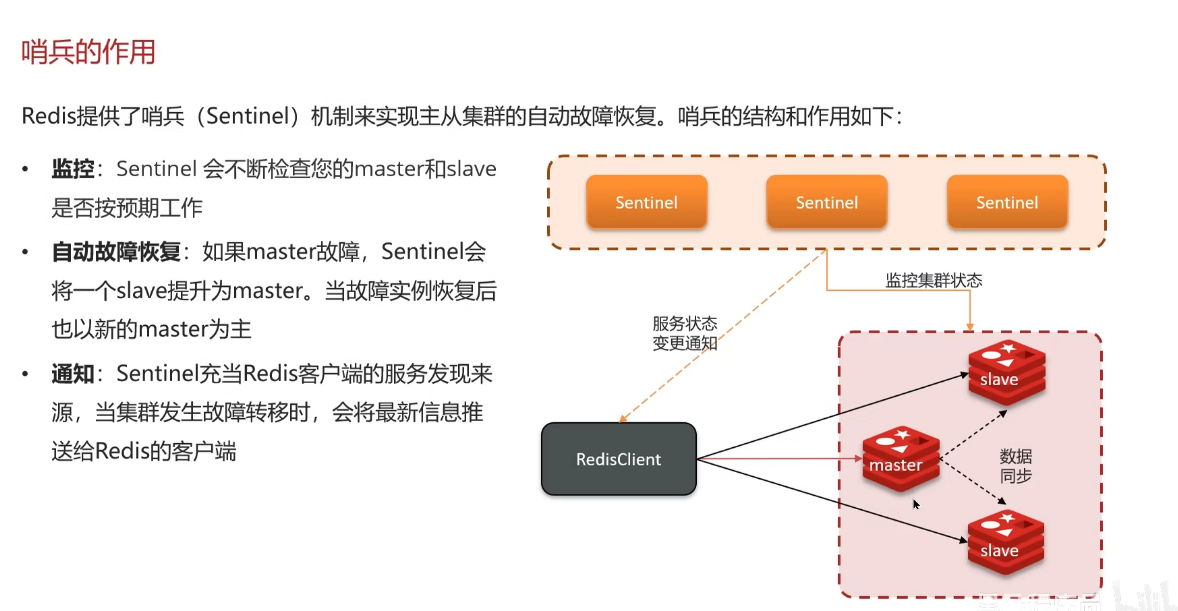
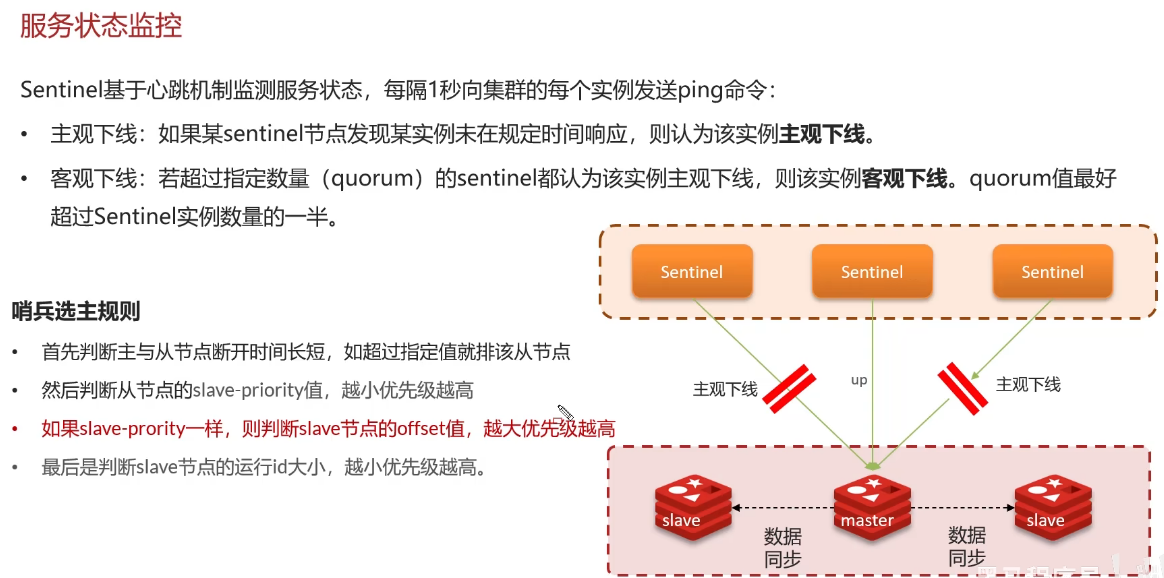
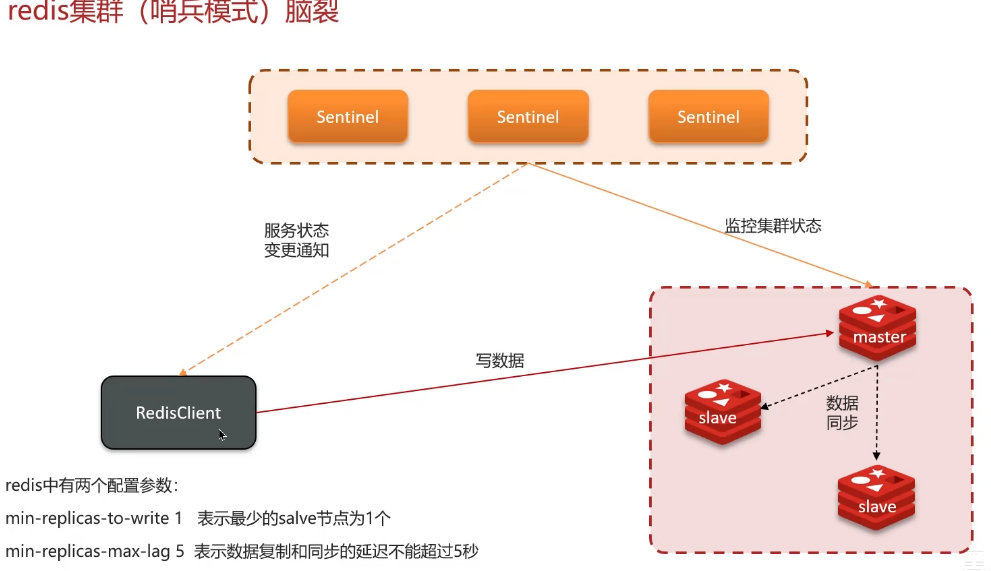
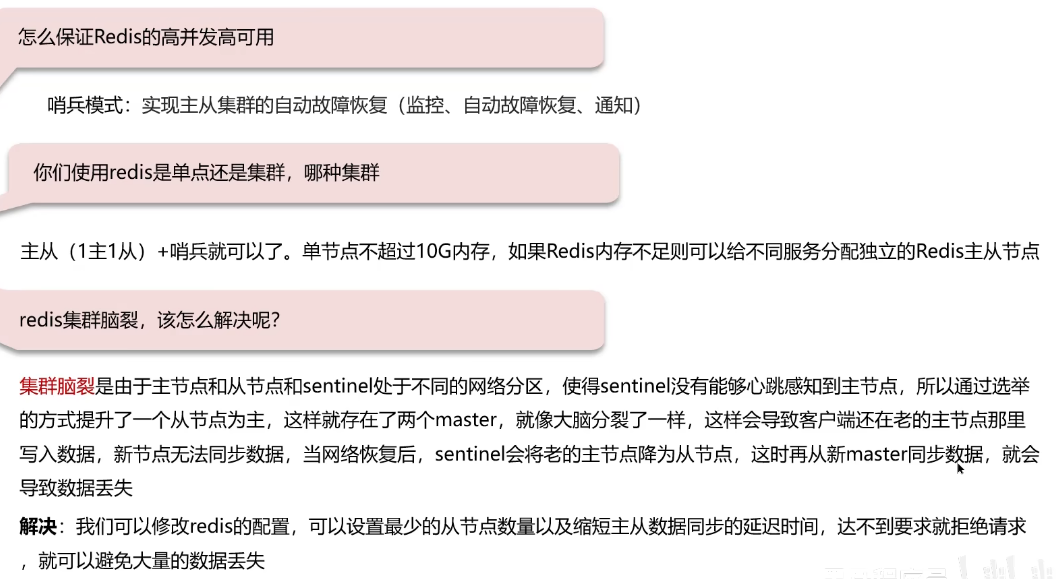
脑裂问题:网络分区导致多个 Master 同时存在,数据冲突。
分片集群
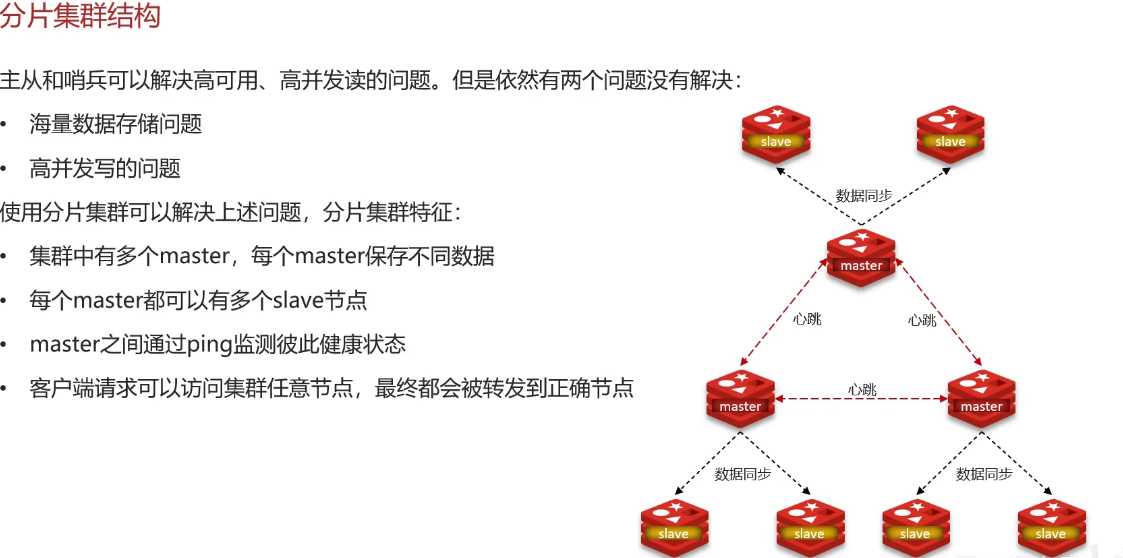
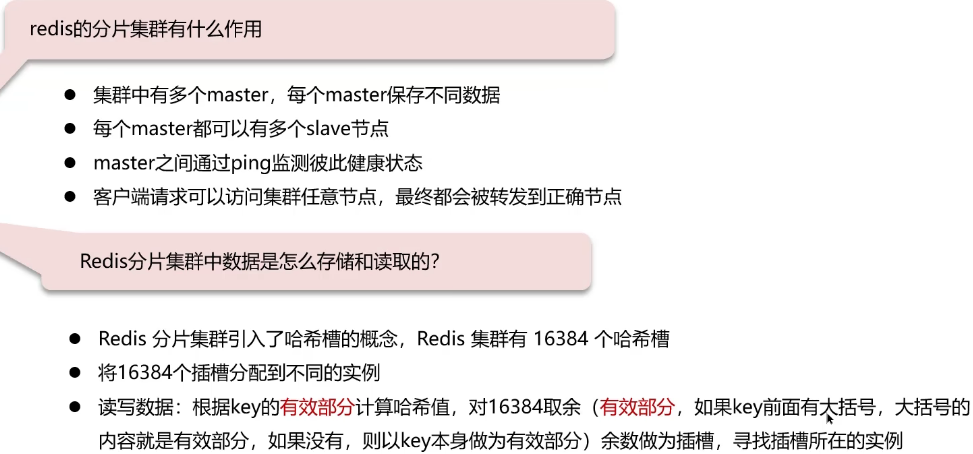
核心机制 — 哈希槽(Hash Slot):16384 个槽位分配给不同主节点,根据 key 计算槽 → 路由到对应节点。
1.9 单线程为什么快 / I/O 模型
Redis 为什么快
- 纯内存操作,执行速度非常快(根本原因)
- 单线程避免不必要的上下文切换和竞争条件
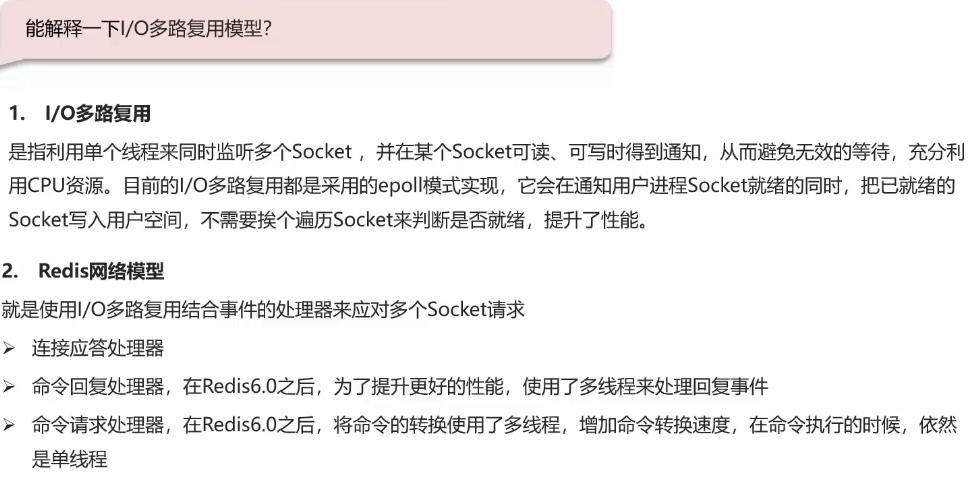
- I/O 多路复用模型,非阻塞 IO
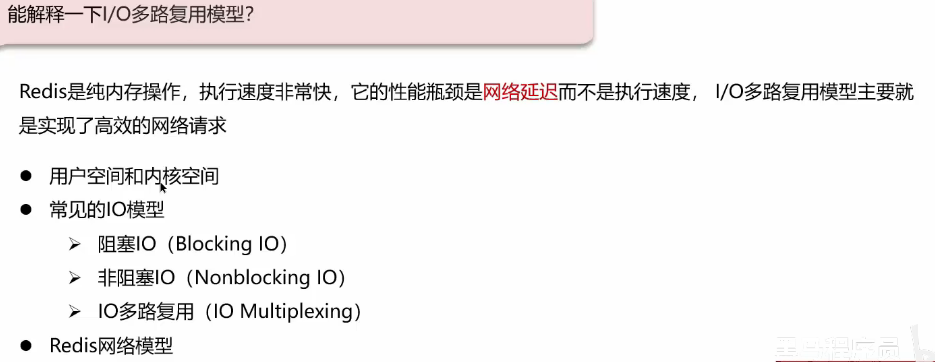
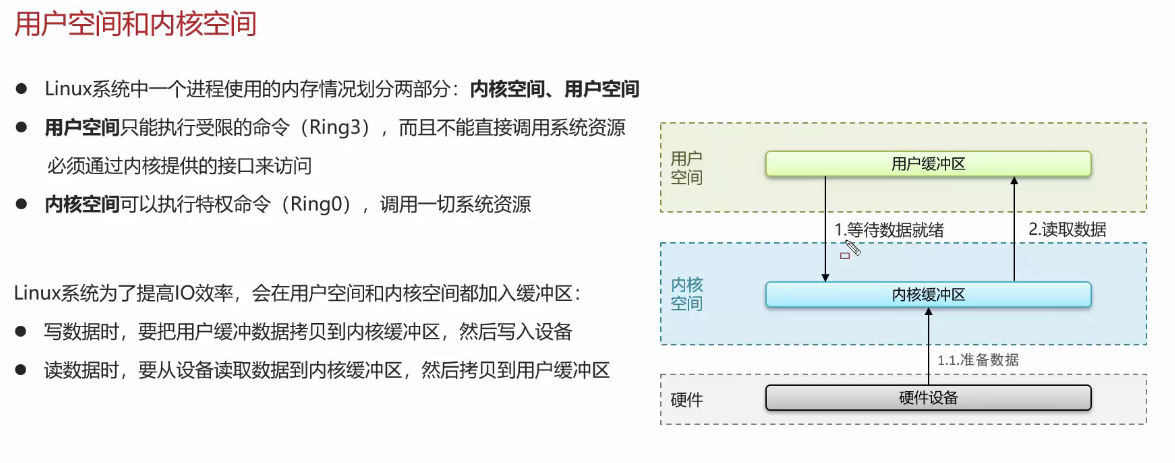
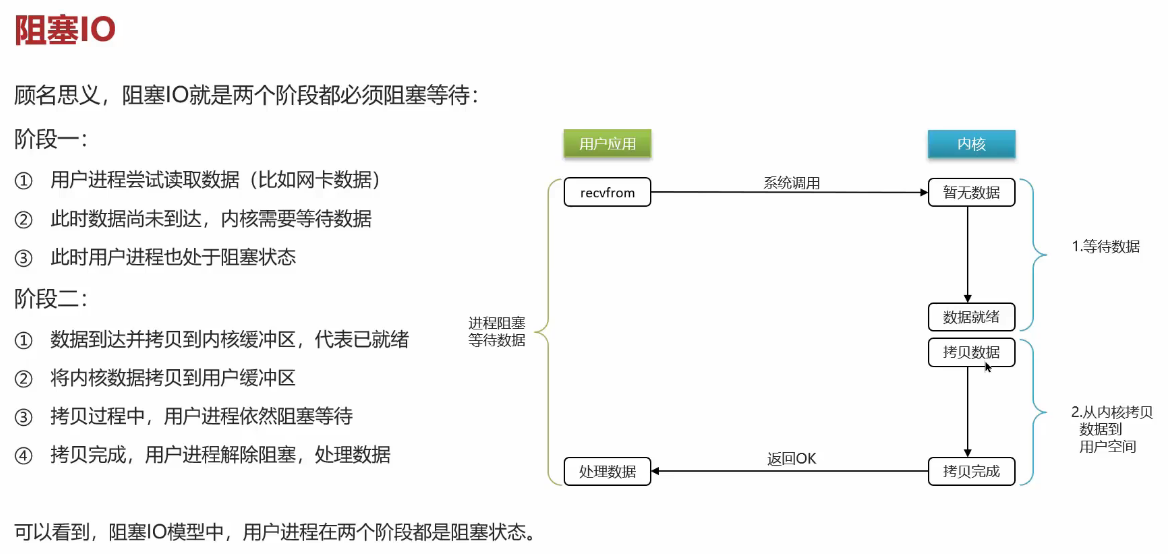
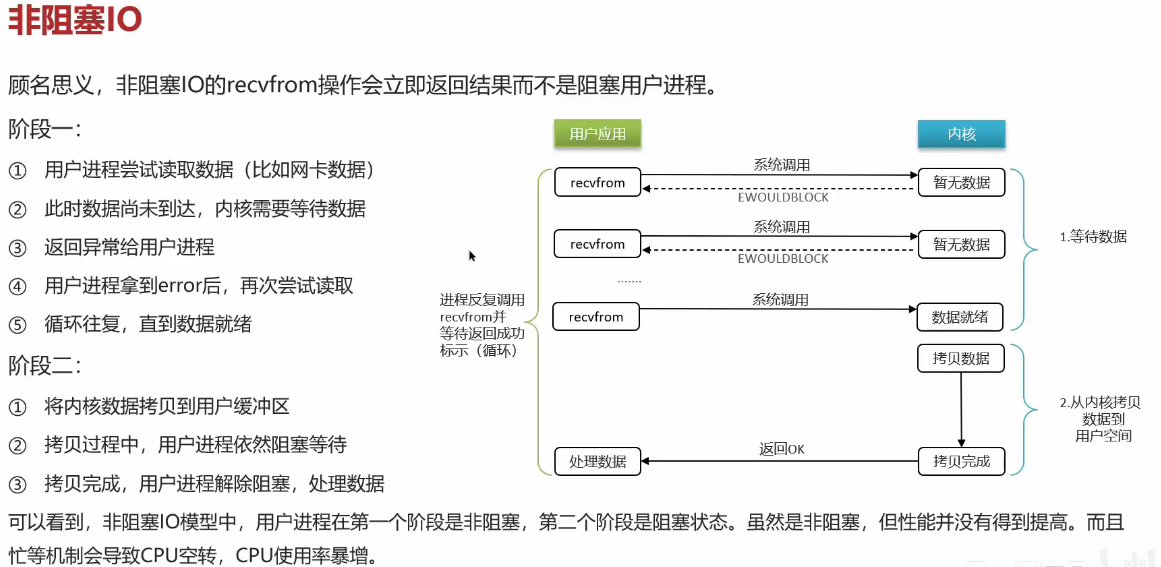
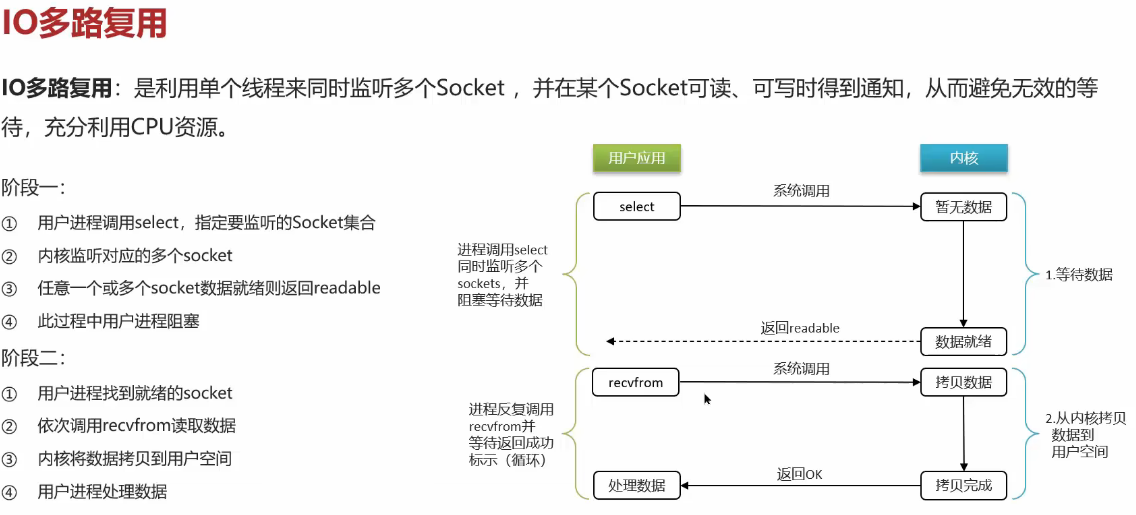
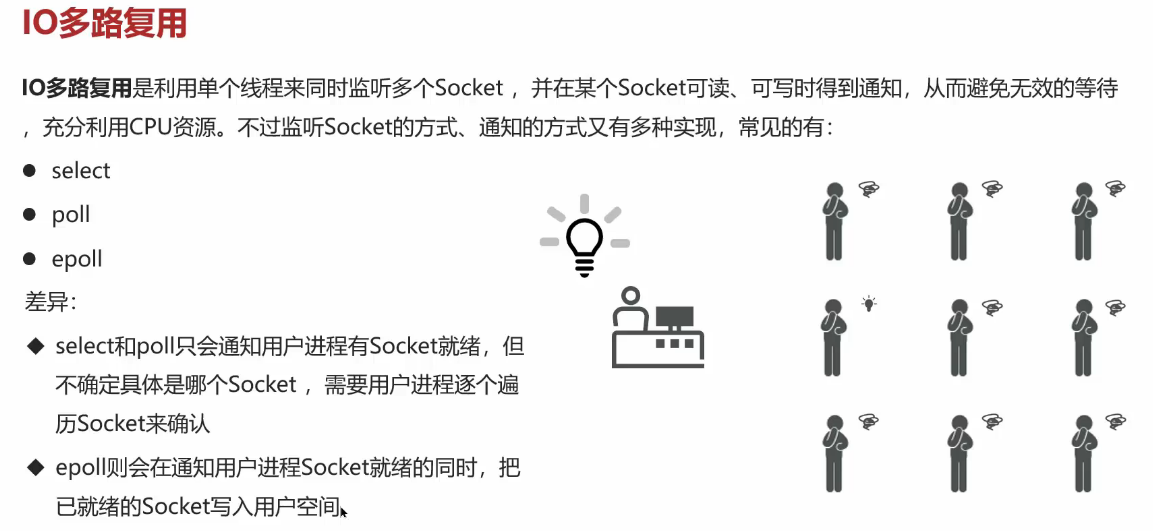
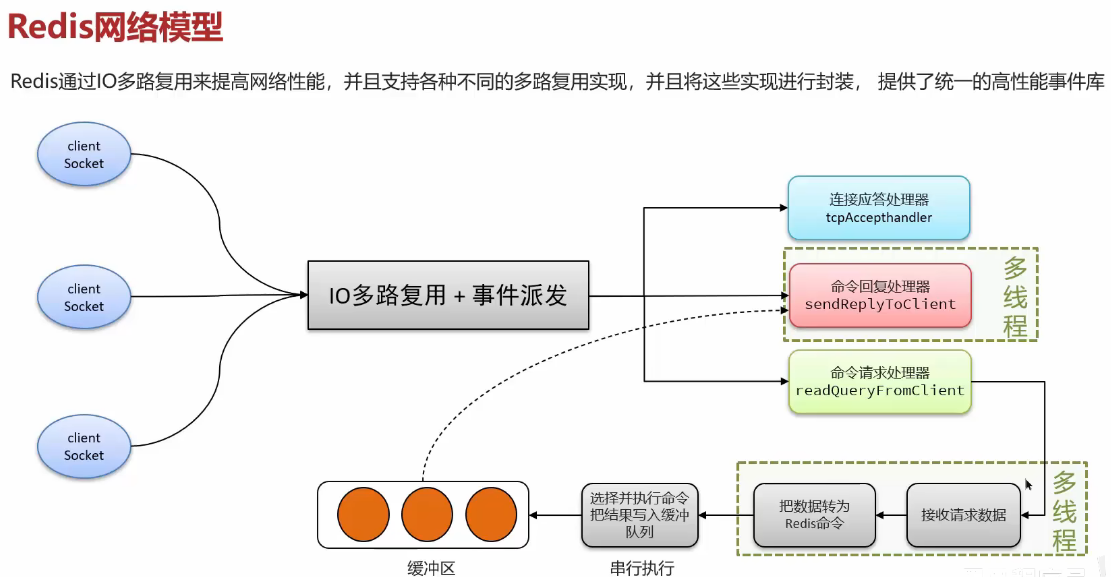
I/O 多路复用及网络模型
二、MySQL
2.1 慢查询定位与 EXPLAIN
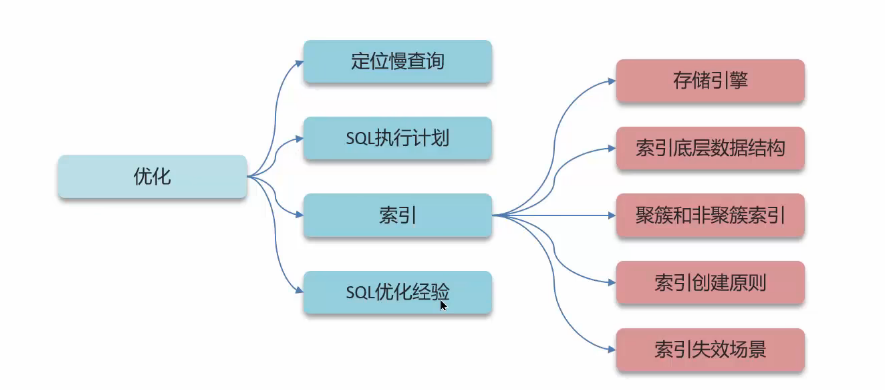
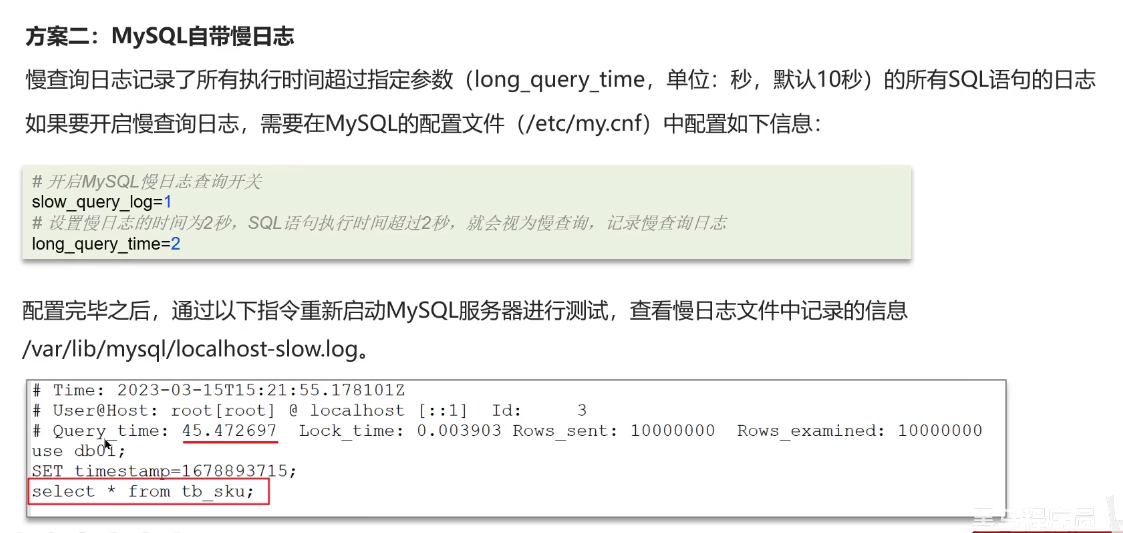
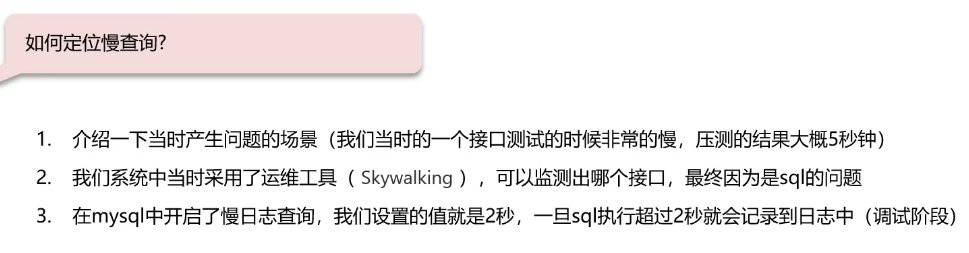
如何定位慢查询
| 方案 | 工具 |
|---|---|
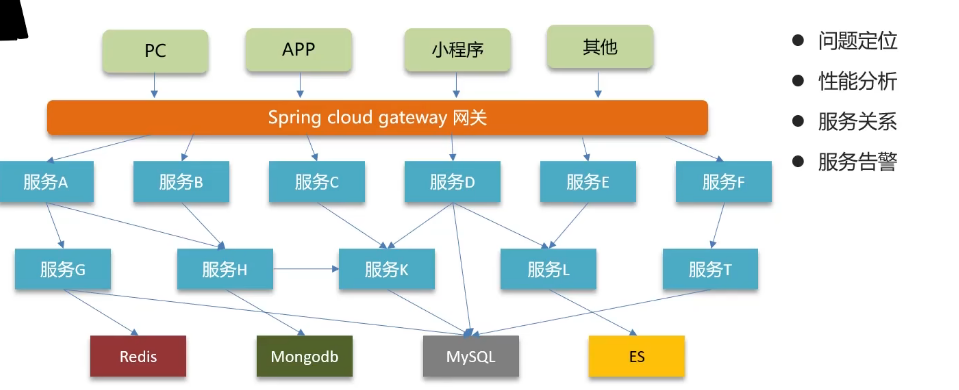
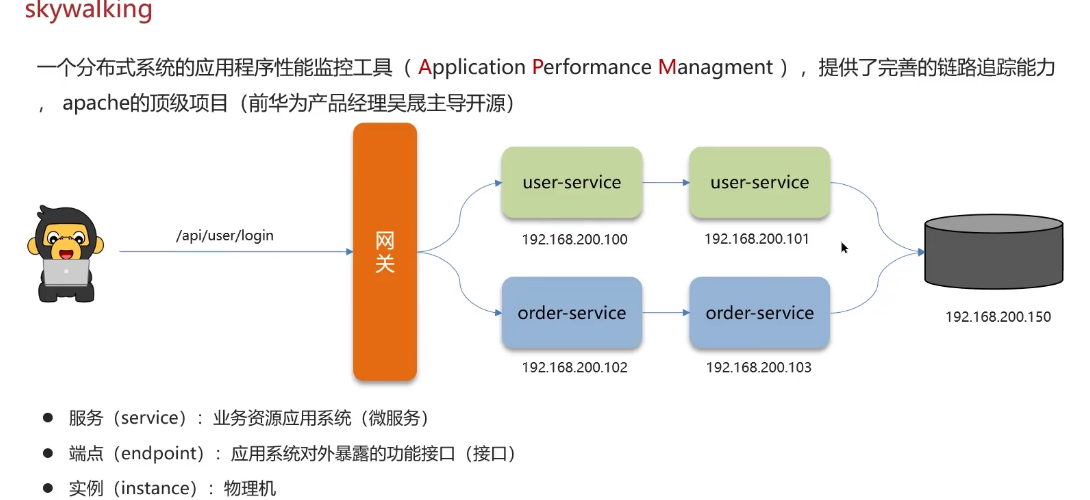
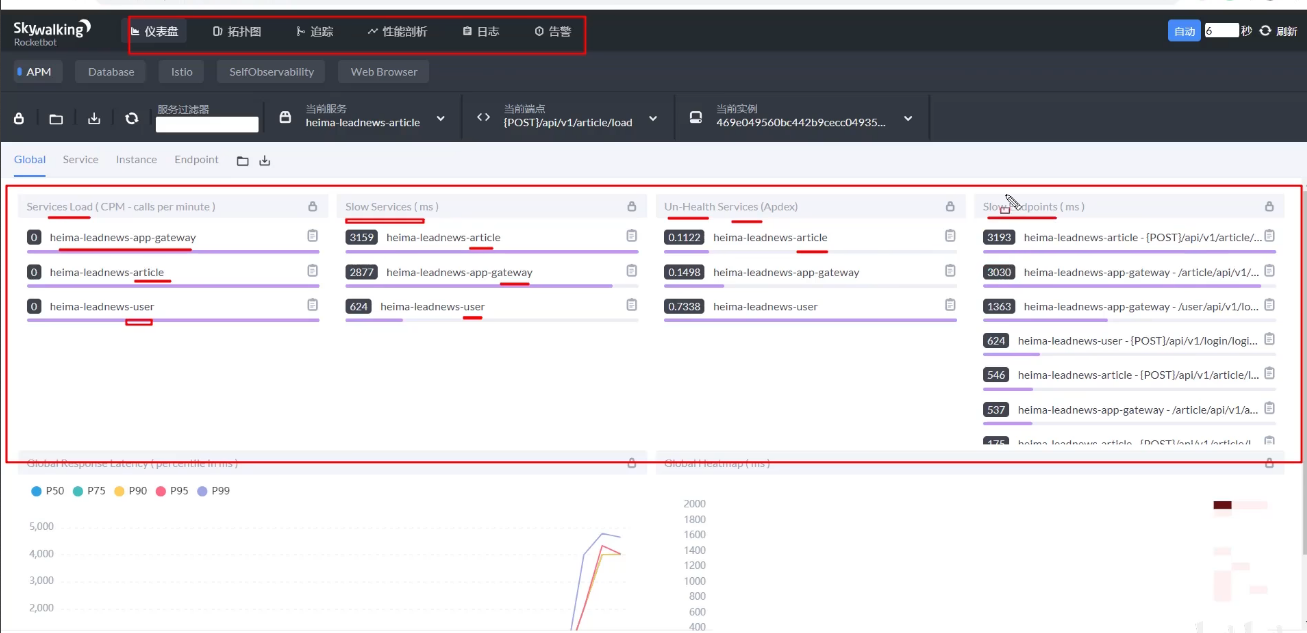
| 开源工具 | Arthas(调试)、Prometheus / Skywalking(运维监控) |
| MySQL 自带 | 慢日志(slow query log) |
EXPLAIN 分析 SQL
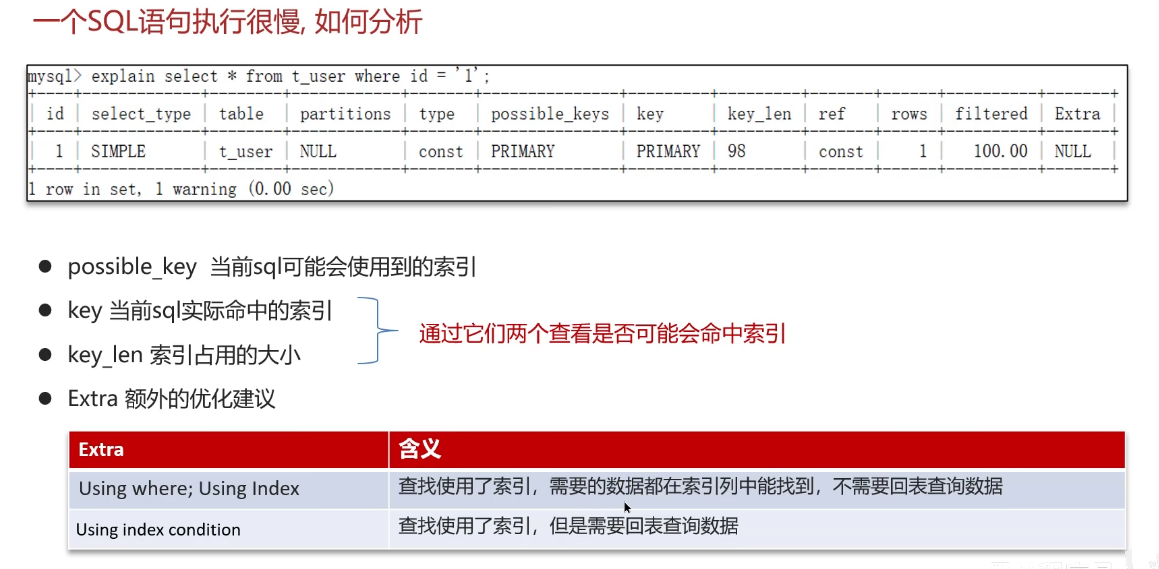
Type 类型(性能由好到差):
NULL → system → const → eq_ref → ref → range → index → ALL2.2 索引
索引结构比较
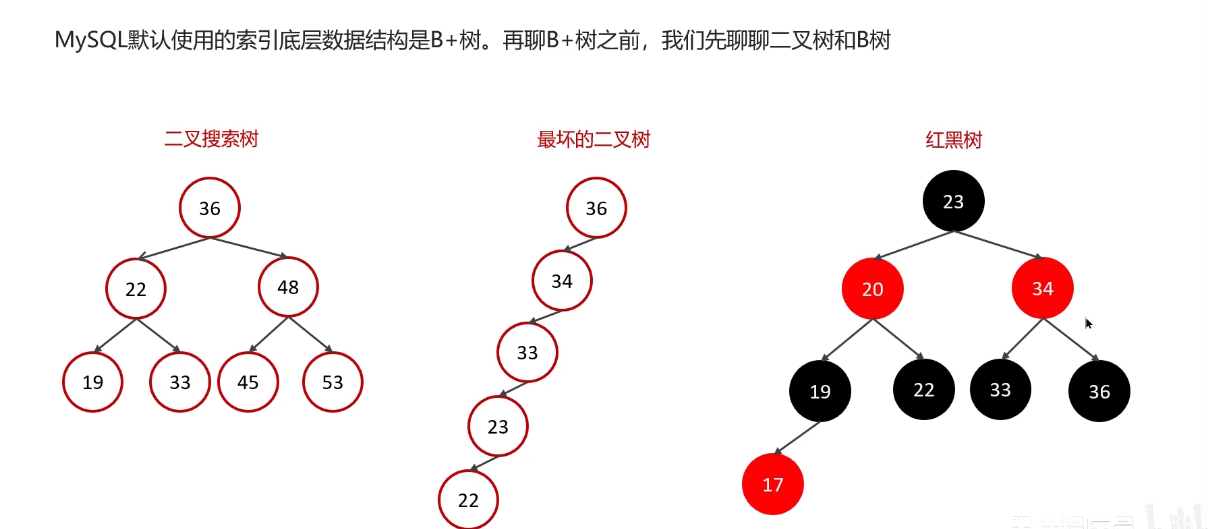
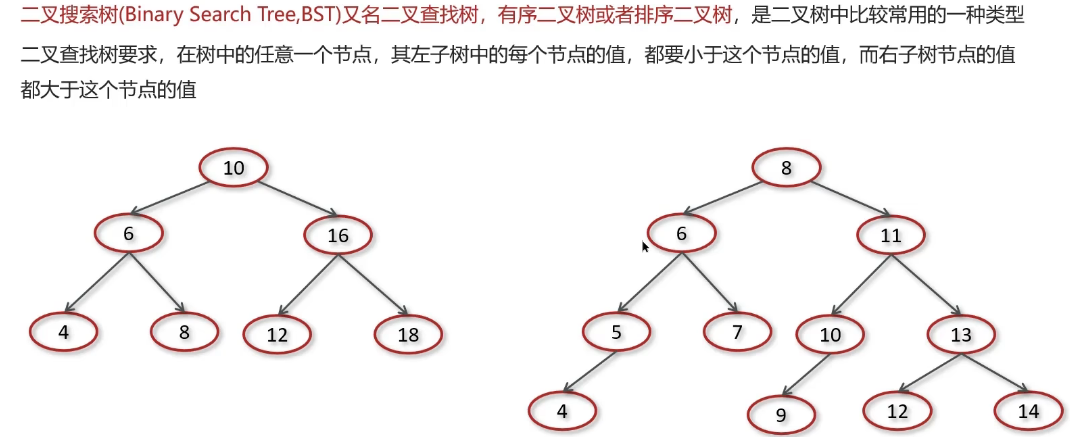
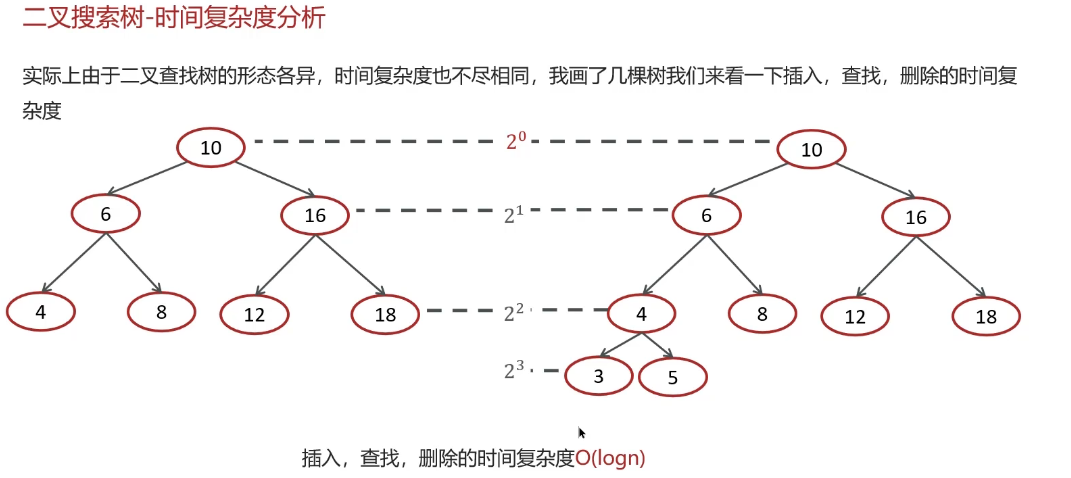
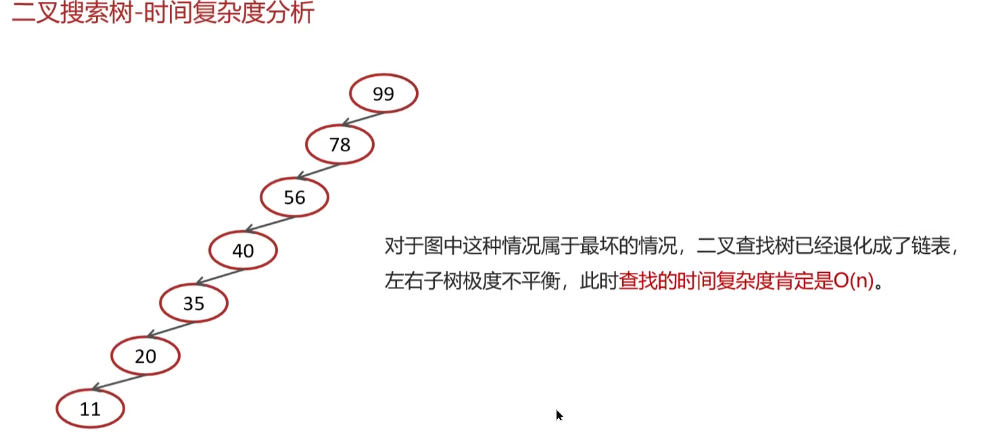
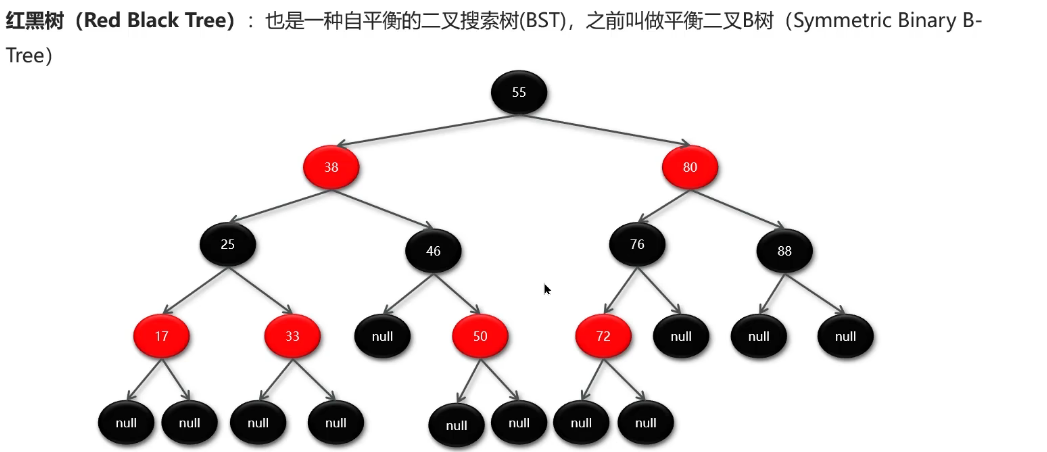
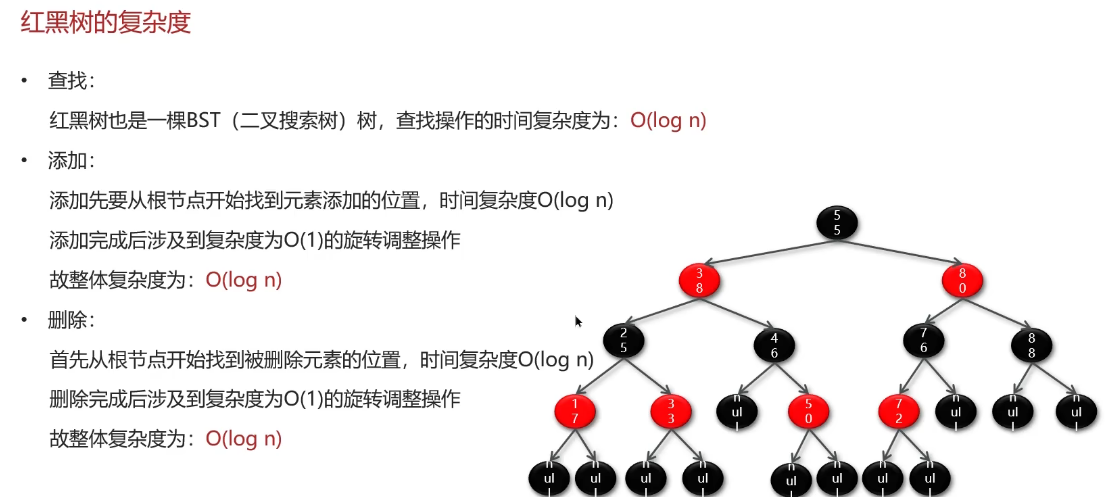
二叉树 / 红黑树的缺点:
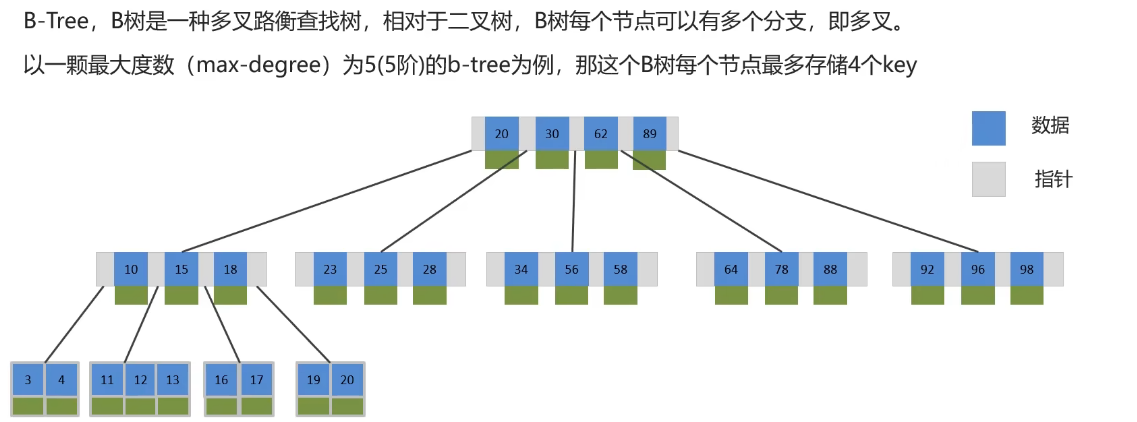
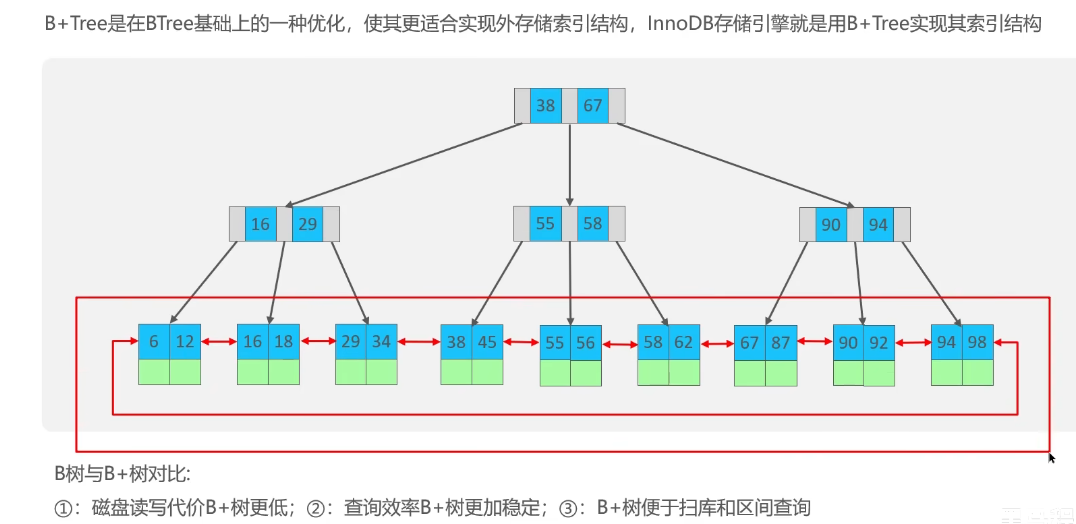
B+ 树:将具体数据都放在叶子节点上,非叶子节点只存索引,进一步提高了效率。
聚簇索引 vs 非聚簇索引 vs 回表
| 概念 | 类比 | 说明 |
|---|---|---|
| 聚簇索引 | 按拼音排序的字典正文 | 索引和数据是一体的,找到索引 = 找到数据 |
| 非聚簇索引 | 偏旁部首检字表 | 索引只告诉你”数据在哪”,还需回表查数据 |
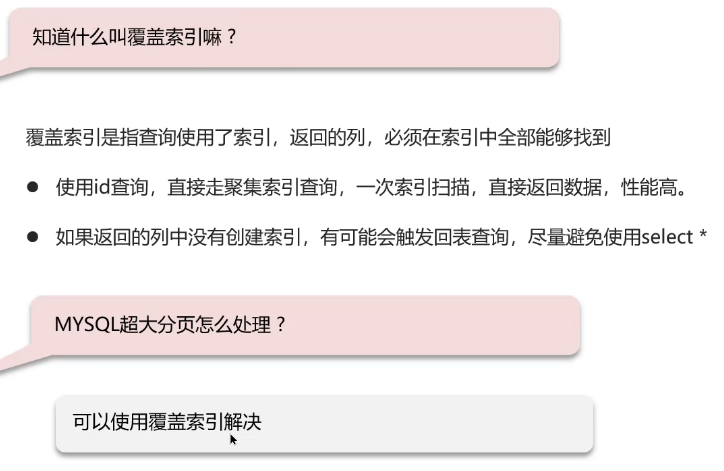
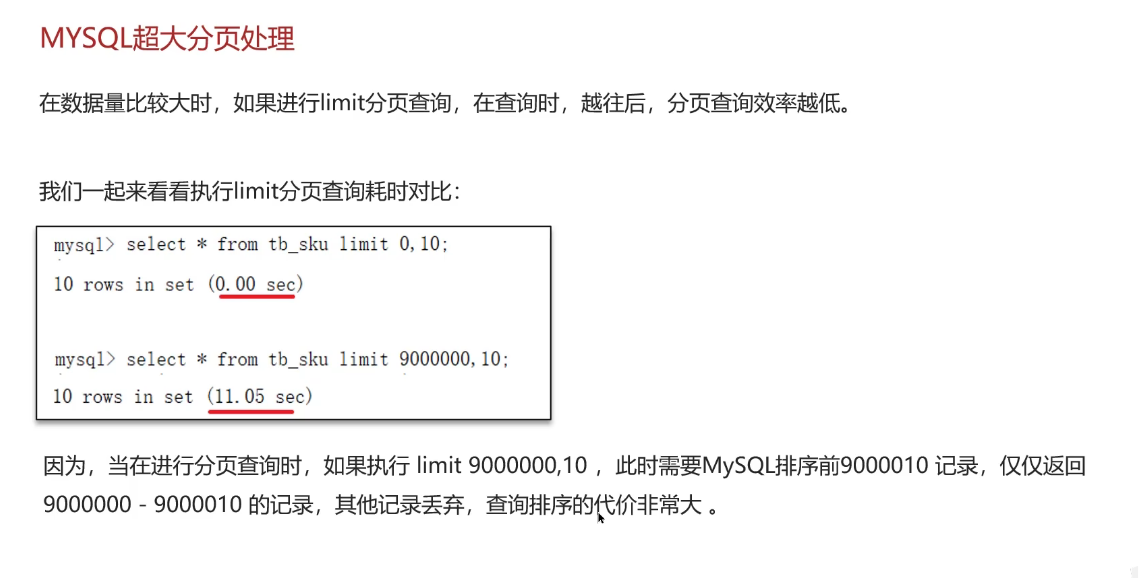
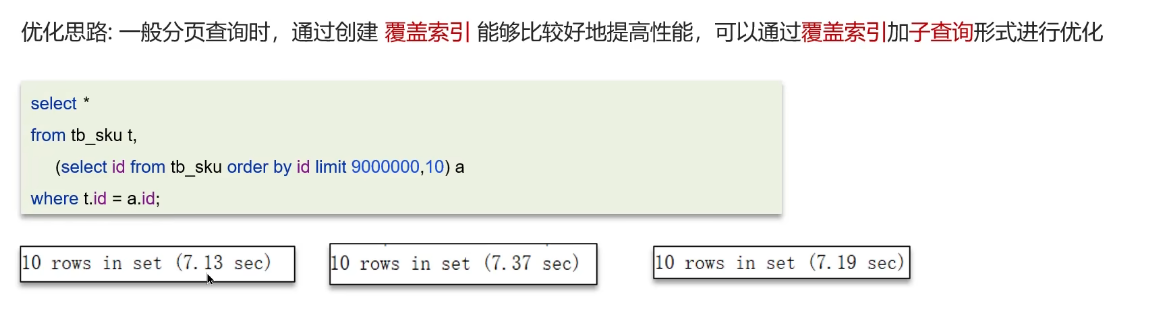
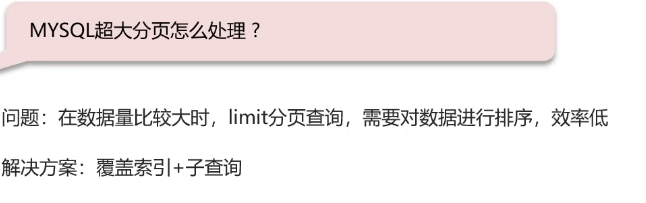
覆盖索引 / 超大分页优化
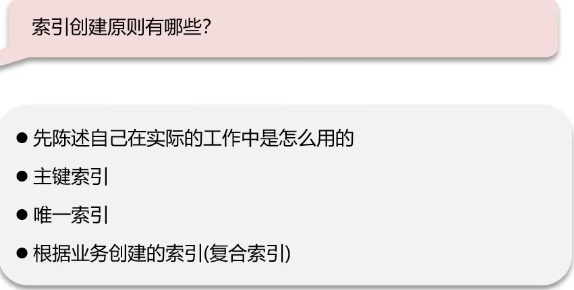
索引创建原则
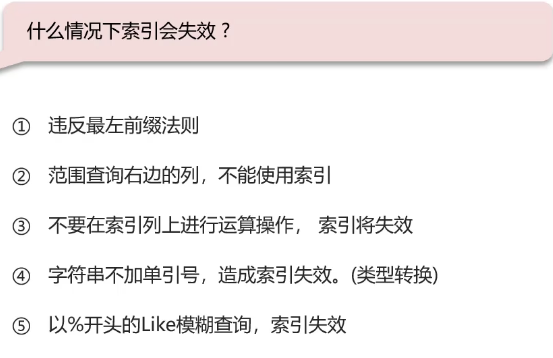
索引失效场景
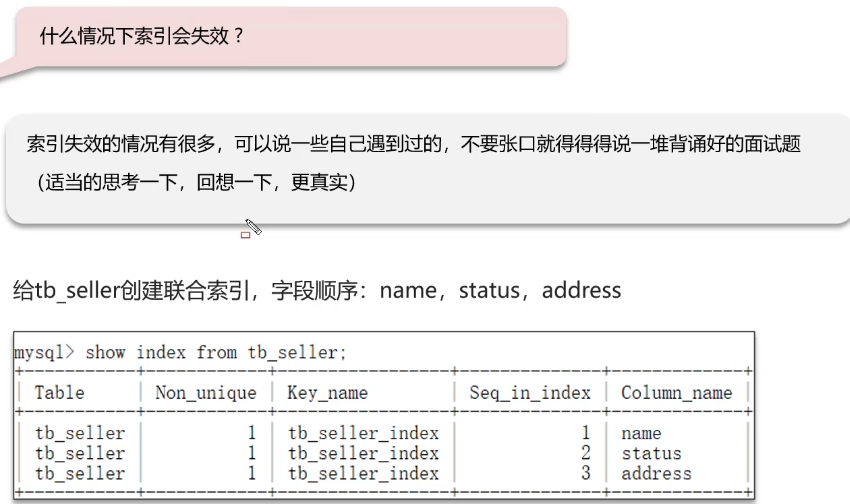
| 场景 | 原因 |
|---|---|
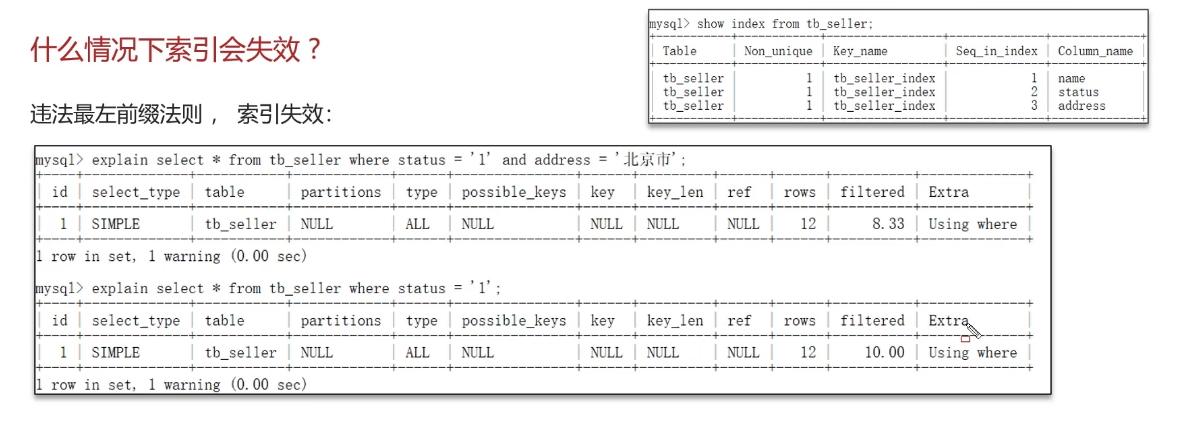
| 违反最左前缀法则 | 联合索引不按顺序使用 |
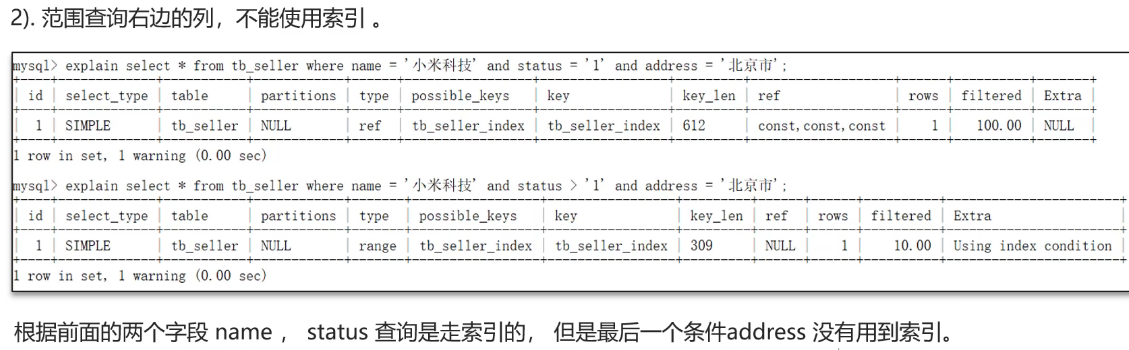
| 范围查询右边的列 | 范围查询会中断索引使用 |
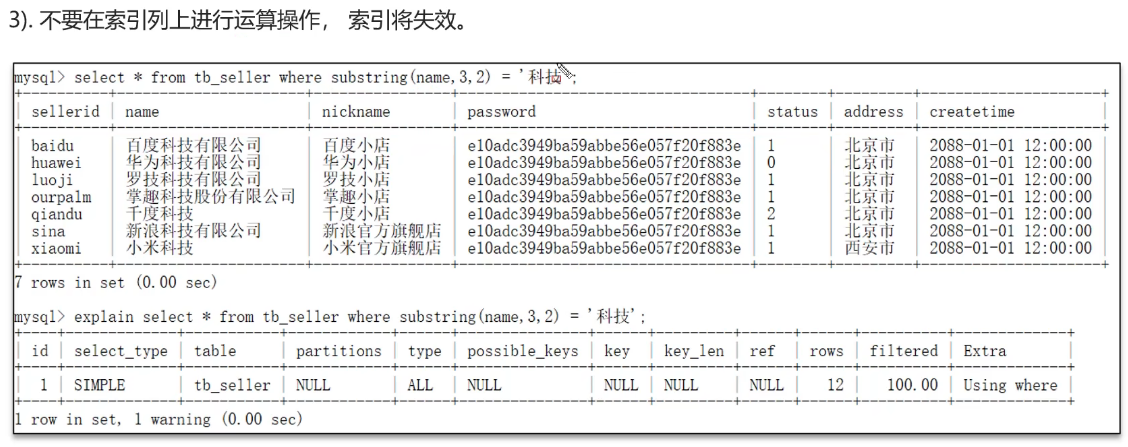
| 索引列上进行运算 | 索引失效 |
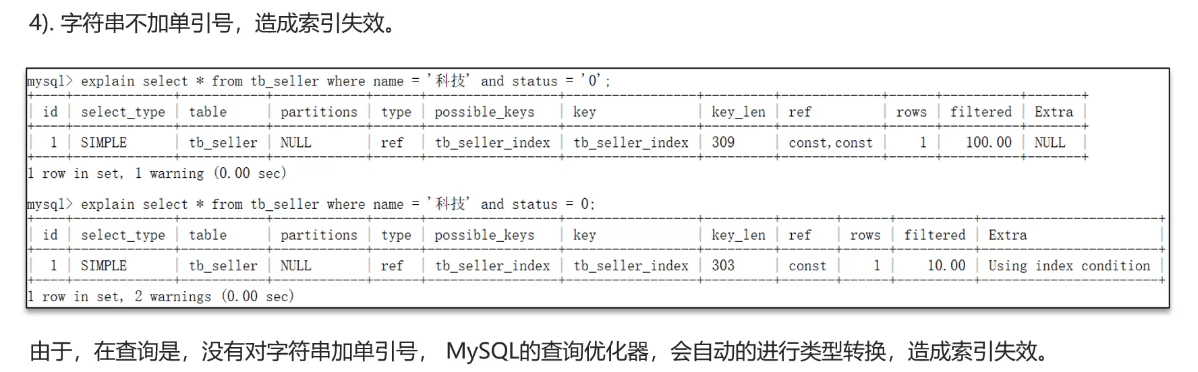
| 字符串不加单引号 | 隐式类型转换导致失效 |
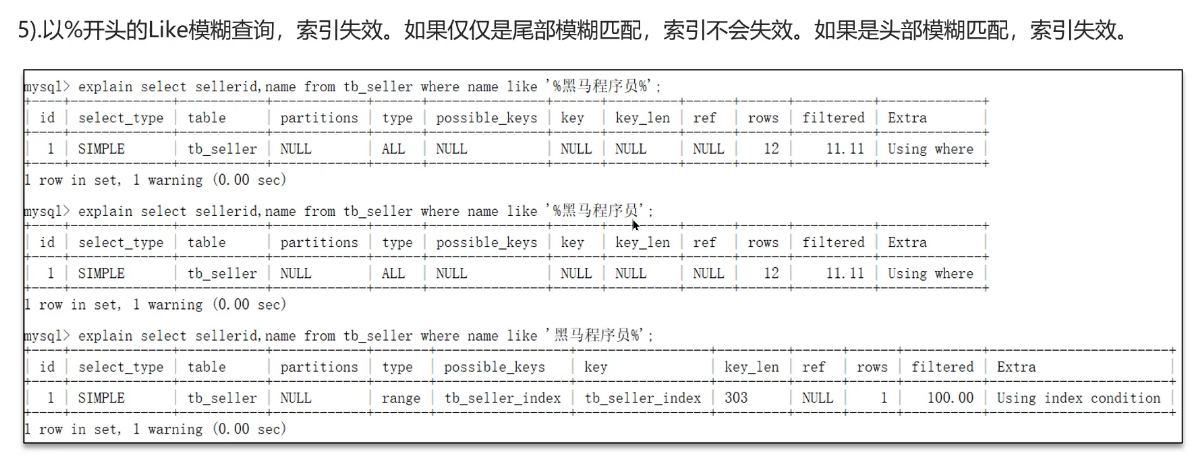
LIKE '%xxx' 以 % 开头 | 前缀模糊无法使用索引 |
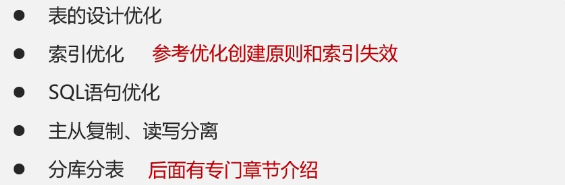
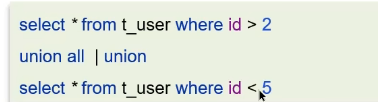
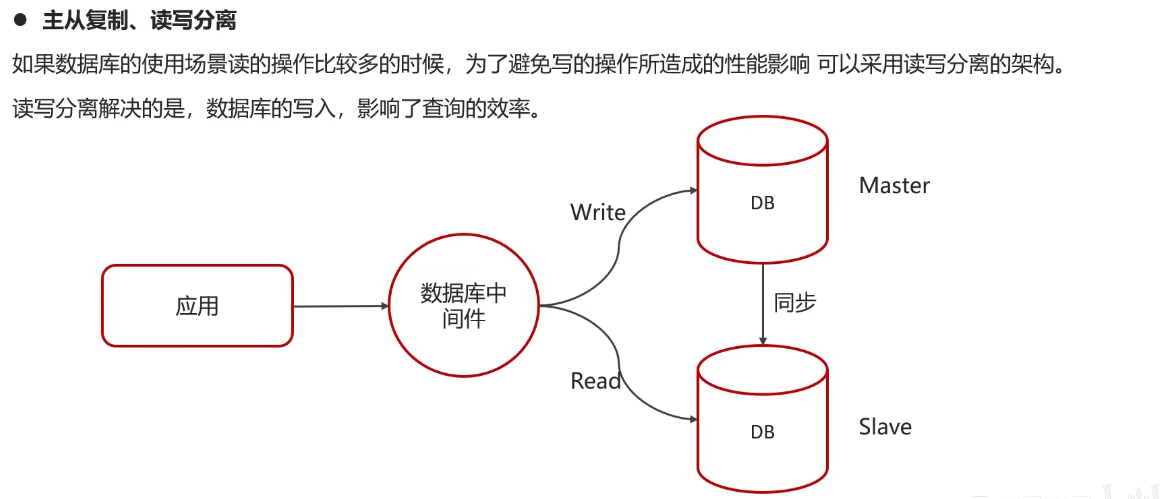
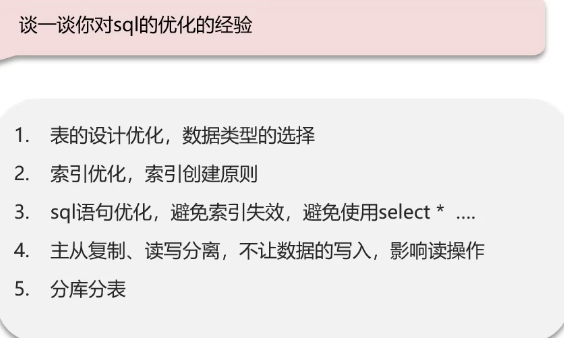
2.3 SQL 优化经验
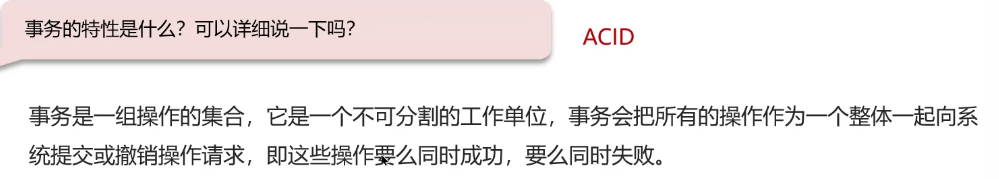
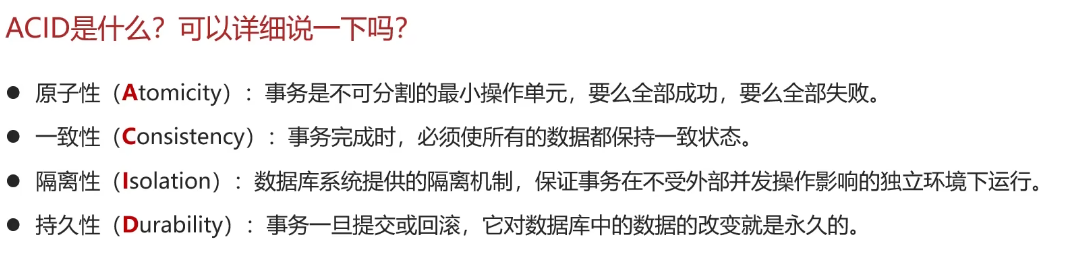
2.4 MySQL 事务
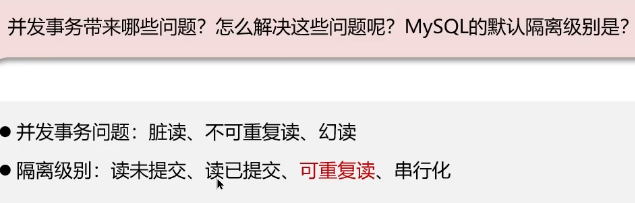
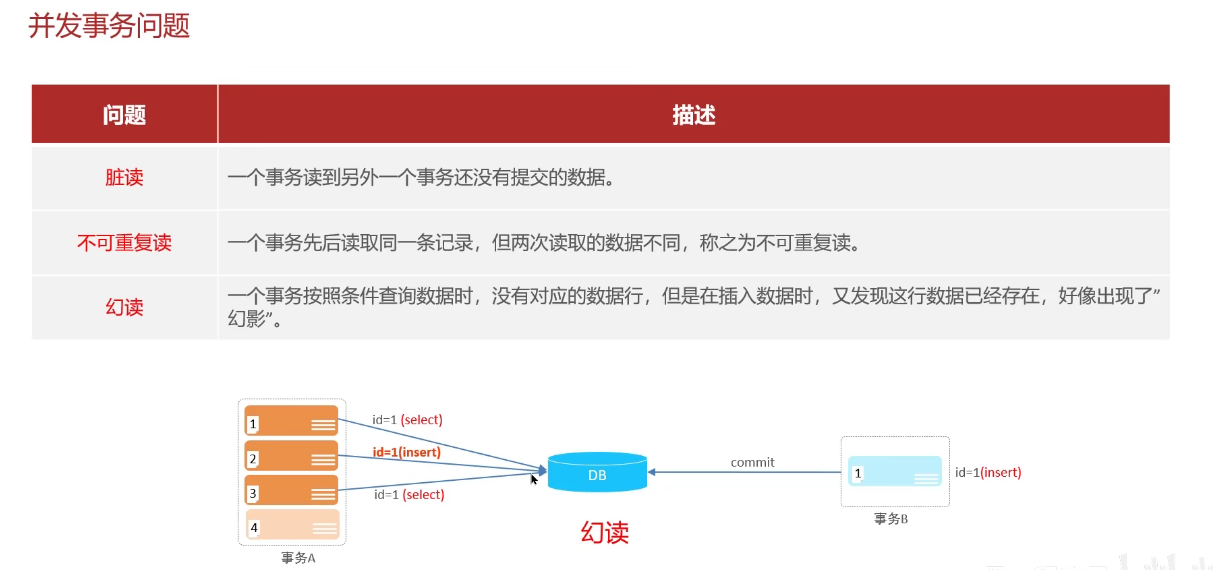
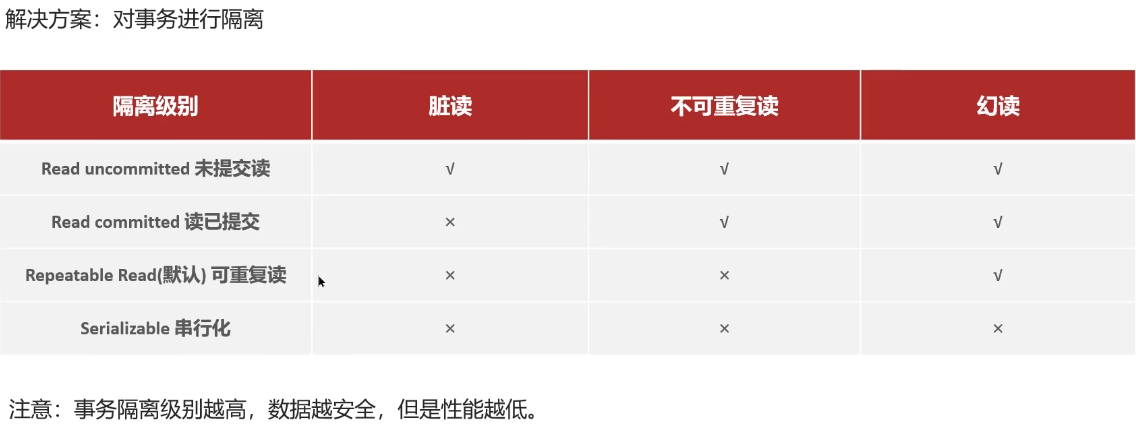
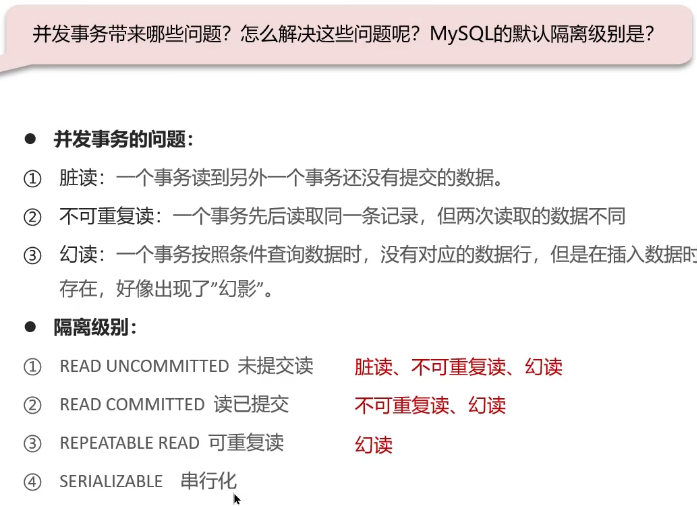
| 隔离级别 | 脏读 | 不可重复读 | 幻读 |
|---|---|---|---|
| READ UNCOMMITTED | ❌ | ❌ | ❌ |
| READ COMMITTED | ✅ | ❌ | ❌ |
| REPEATABLE READ(默认) | ✅ | ✅ | ❌(部分解决) |
| SERIALIZABLE | ✅ | ✅ | ✅ |
三、Spring
3.1 单例 Bean 线程安全
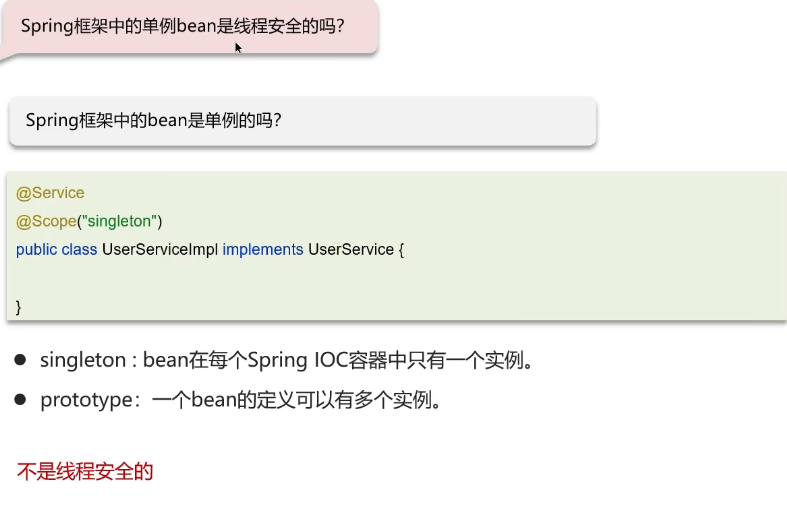
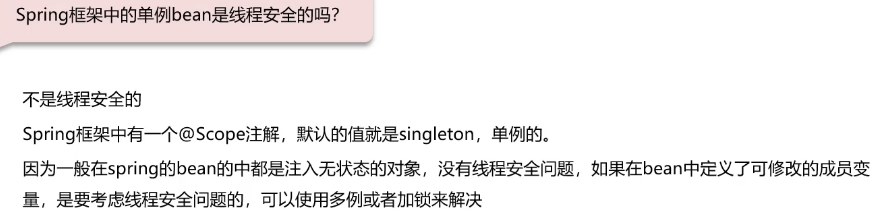
Spring 的 Bean 默认是单例的。是否线程安全取决于 Bean 是否有状态(成员变量)。无状态的 Bean 是线程安全的。
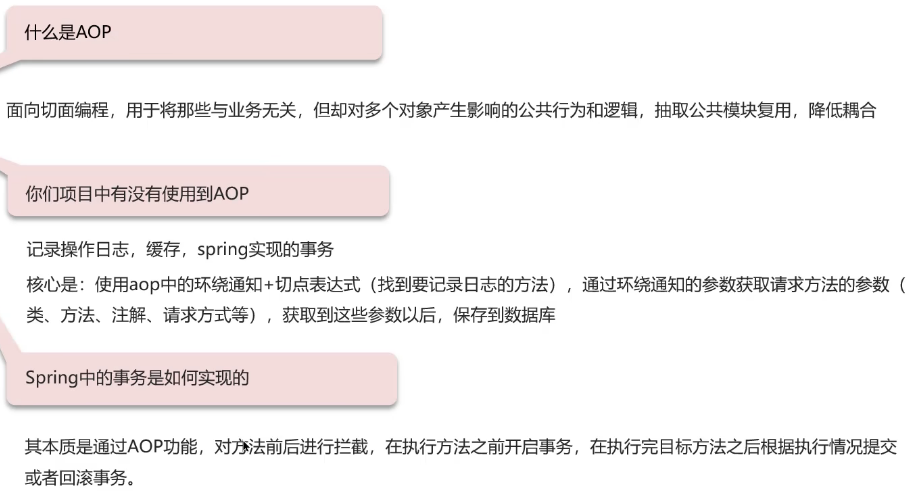
3.2 AOP
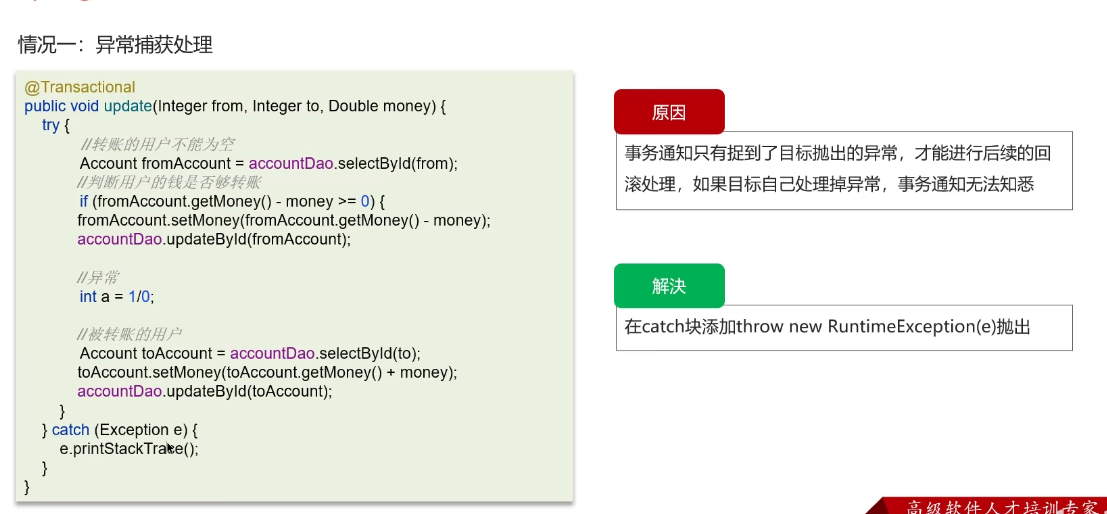
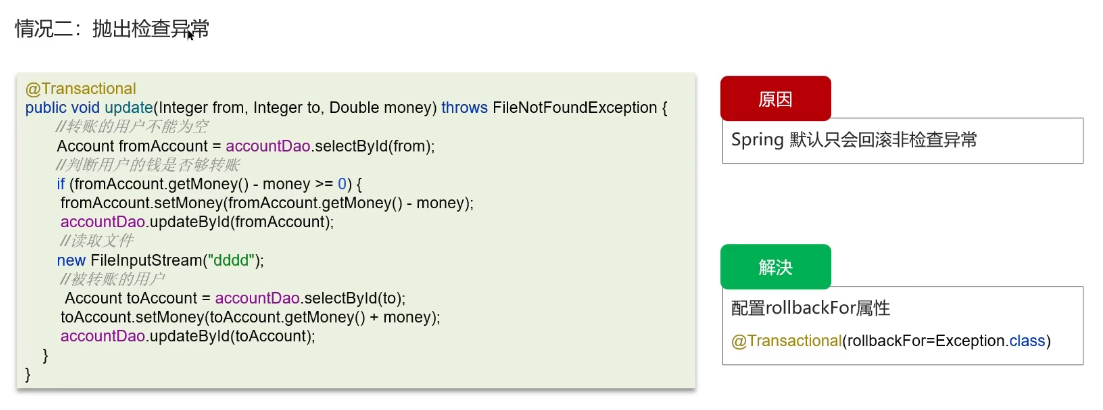
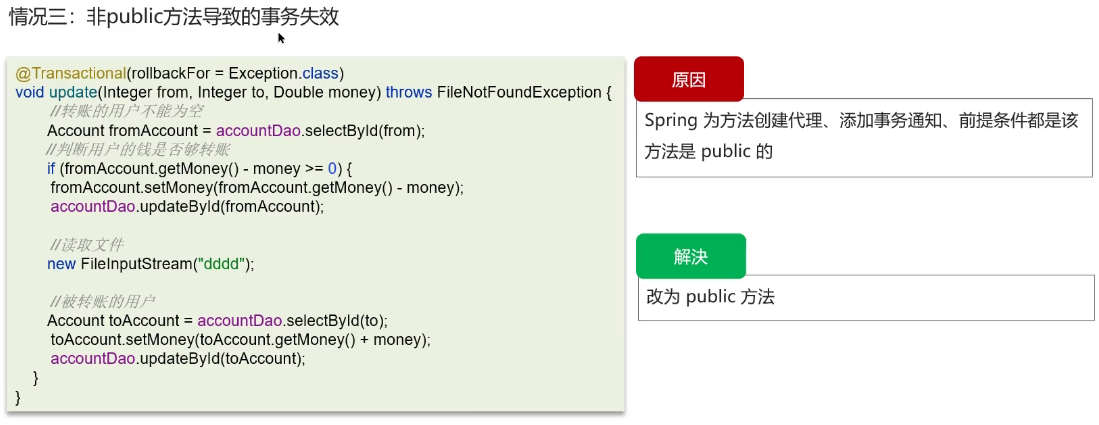
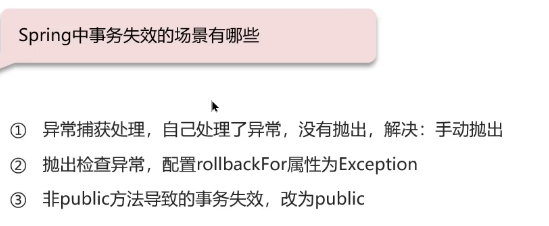
3.3 Spring 事务失效场景
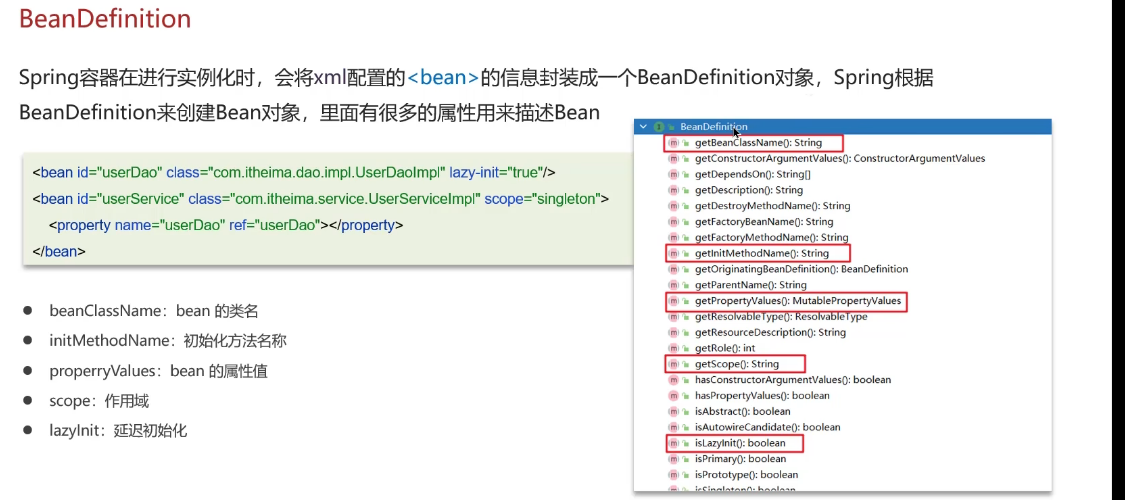
3.4 Bean 生命周期与循环依赖
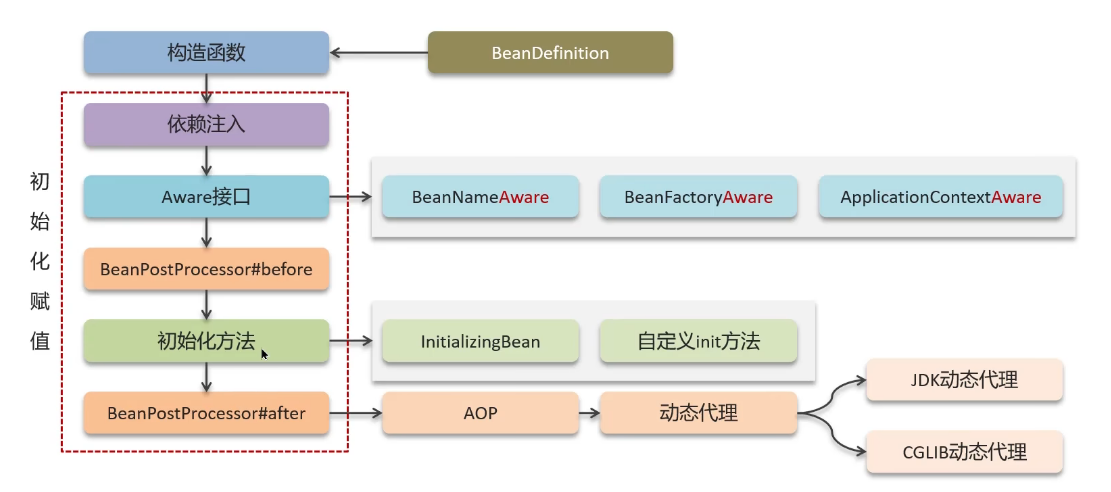
核心流程:
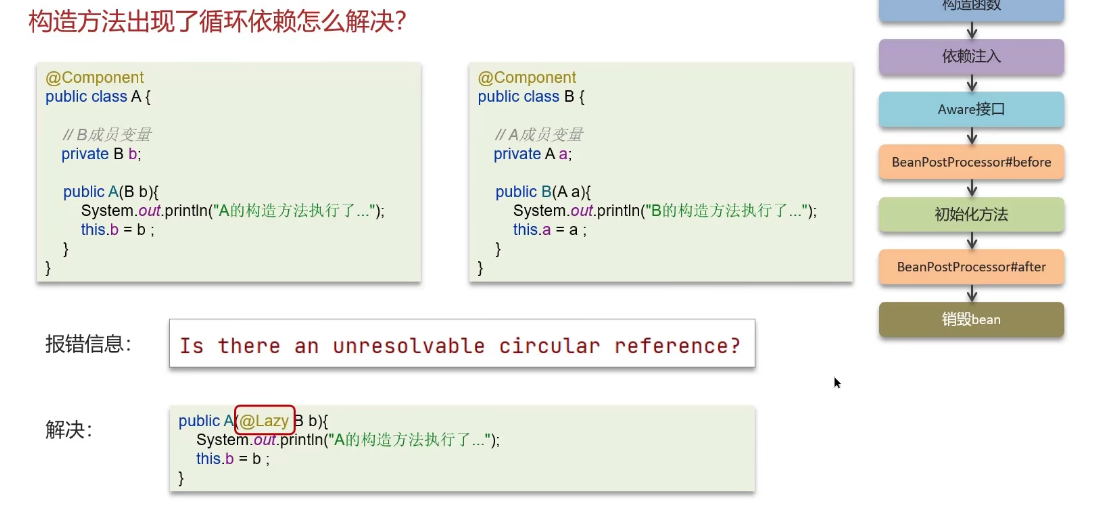
构造函数 → 依赖注入 → Aware 接口 → BeanPostProcessor#before
→ InitializingBean → 自定义 init → BeanPostProcessor#after(AOP 发生地)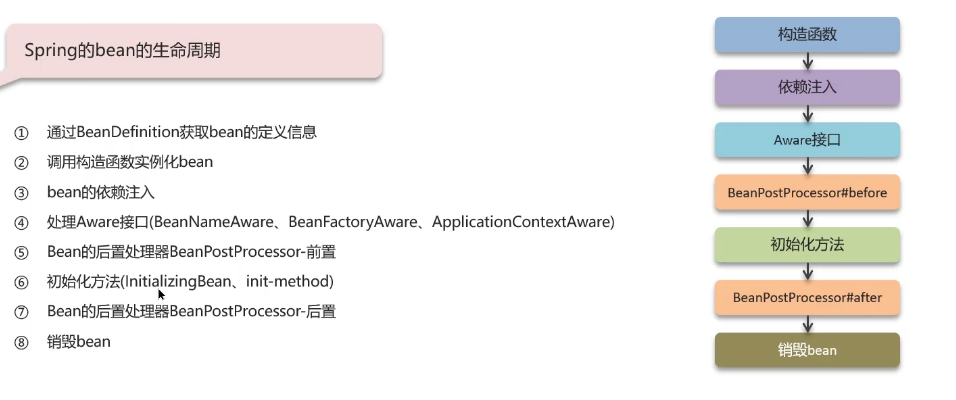
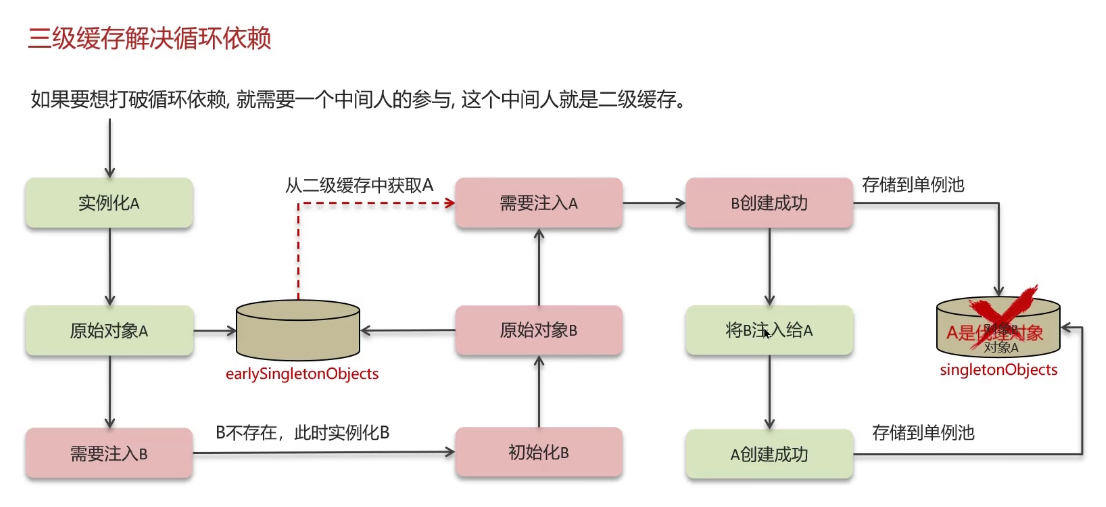
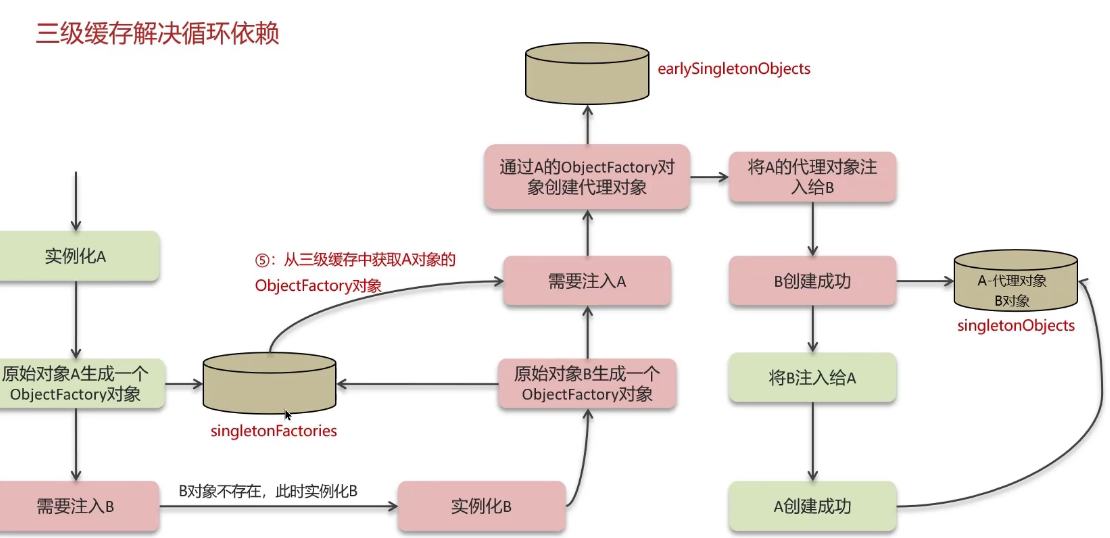
循环依赖
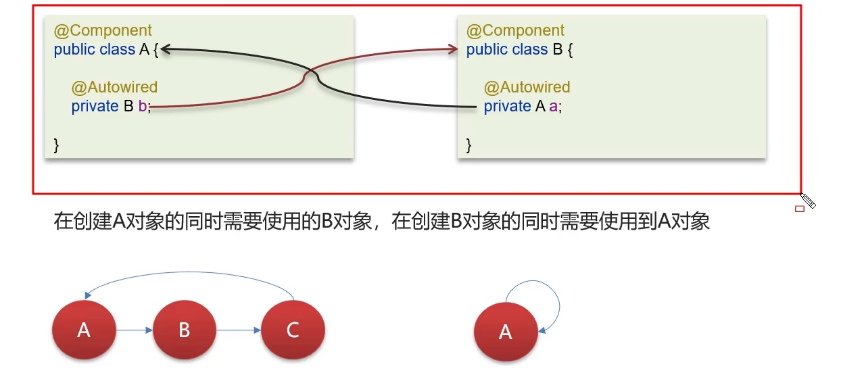
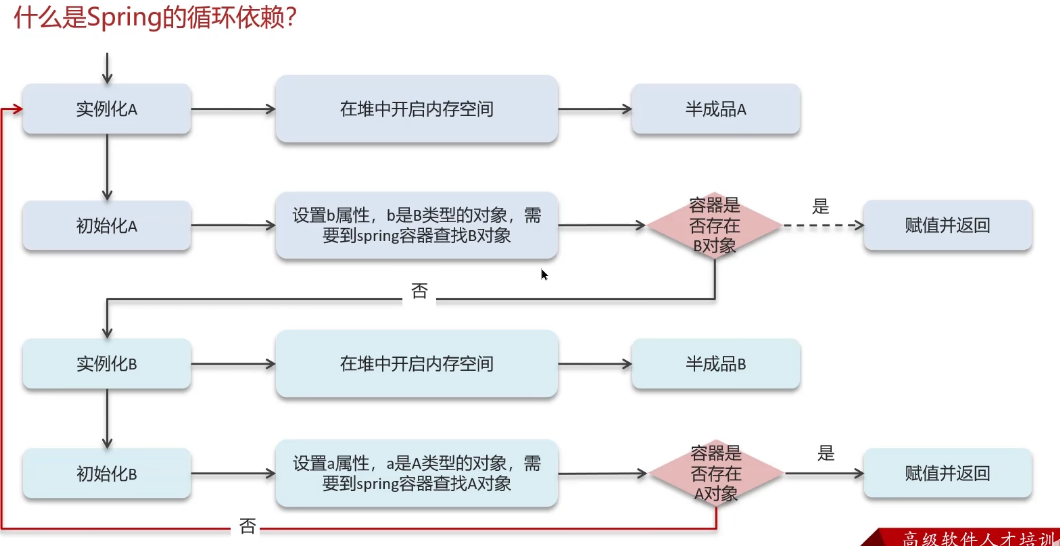
三级缓存解决:
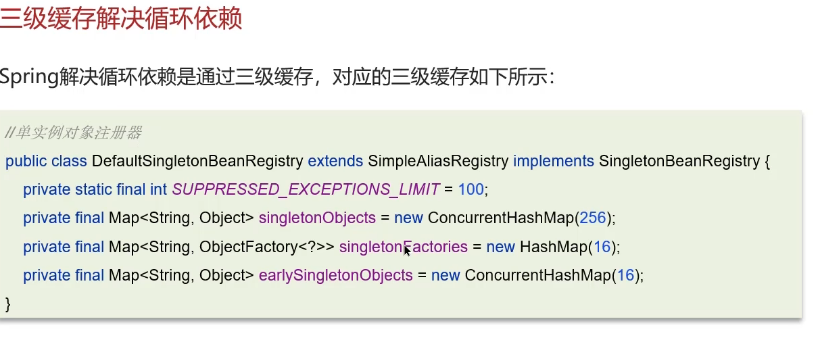
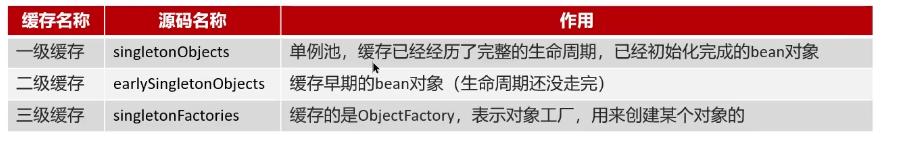
| 缓存 | 名称 | 存放内容 |
|---|---|---|
| 一级缓存 | singletonObjects | 完全初始化好的 Bean |
| 二级缓存 | earlySingletonObjects | 早期的半成品 Bean(已实例化但未注入) |
| 三级缓存 | singletonFactories | Bean 工厂(可生成代理对象) |
3.5 Spring MVC 执行流程
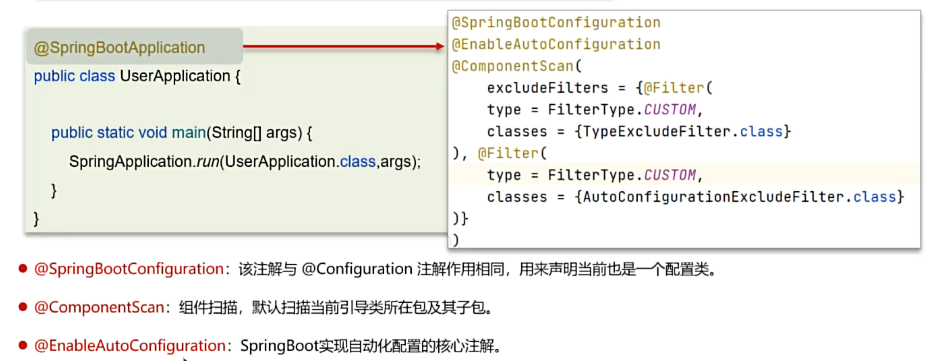
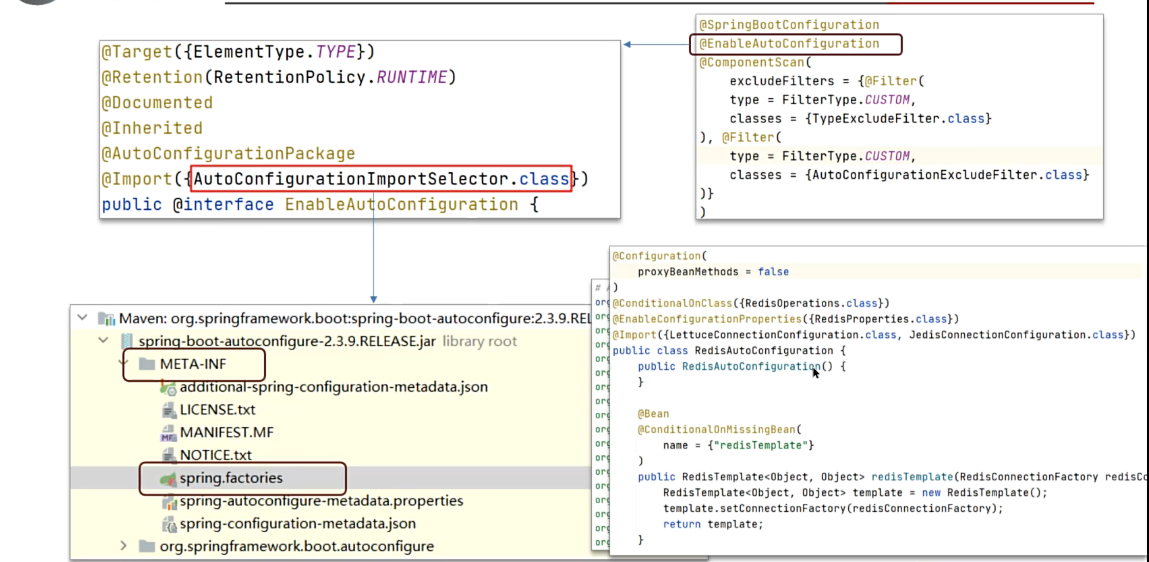
3.6 Spring Boot 自动配置
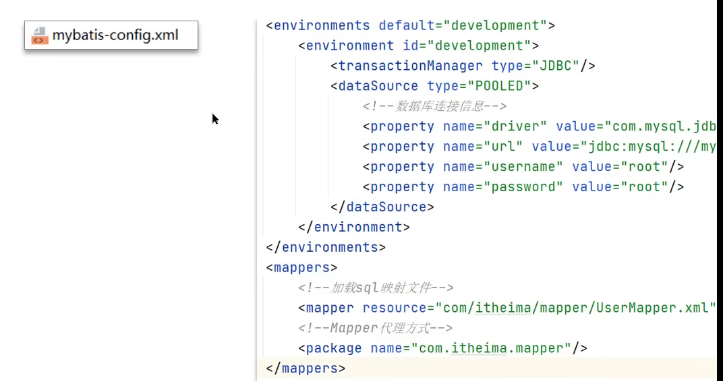
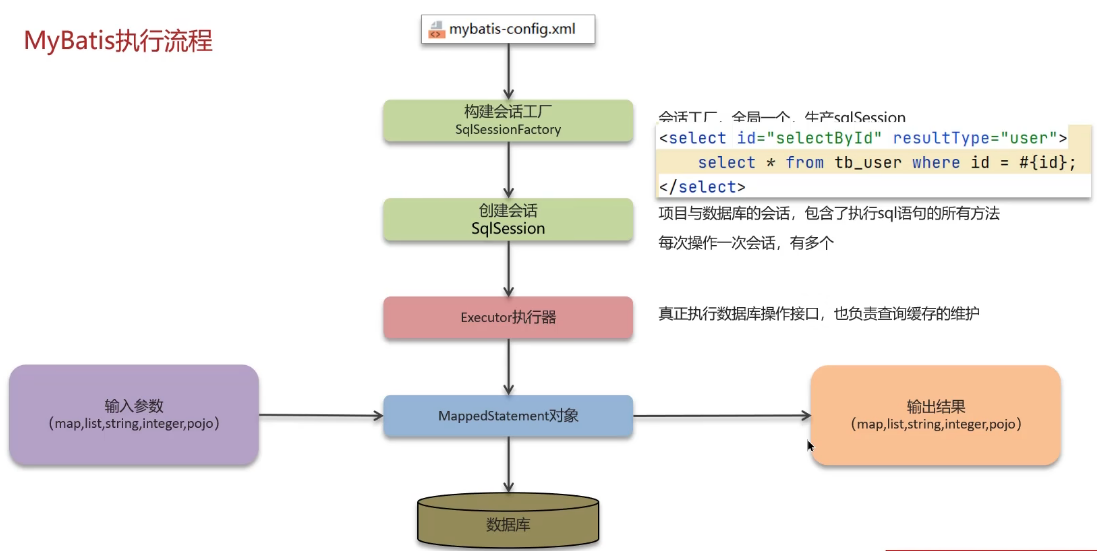
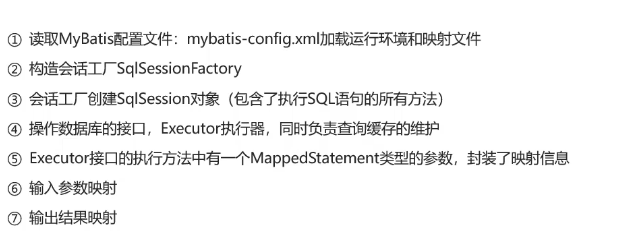
3.7 MyBatis
四、微服务
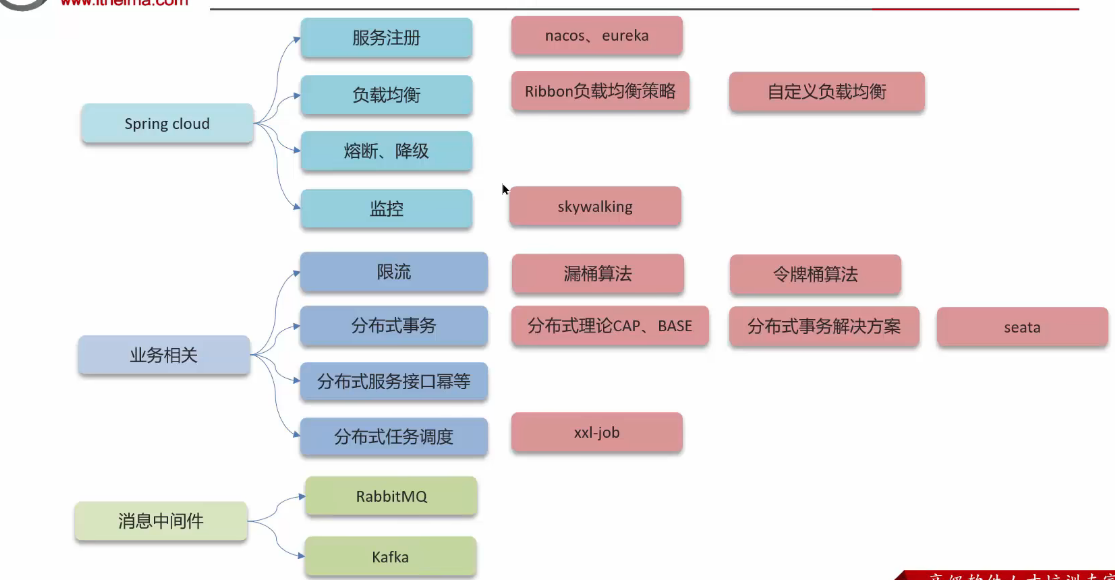
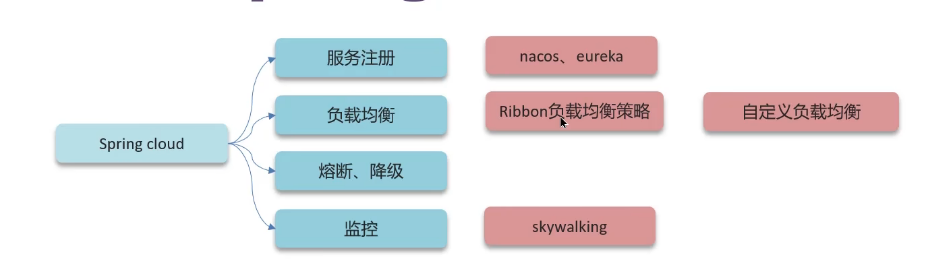
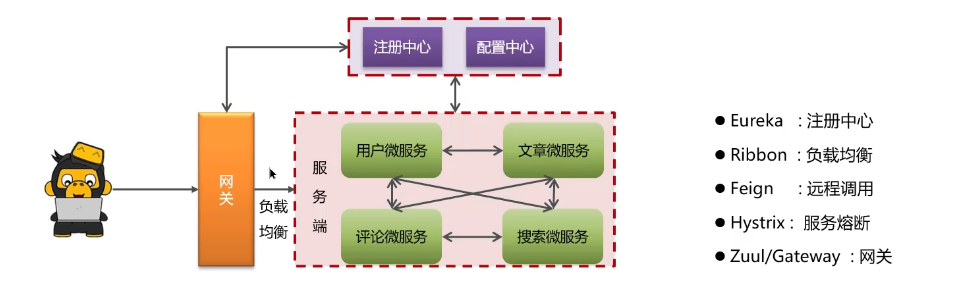
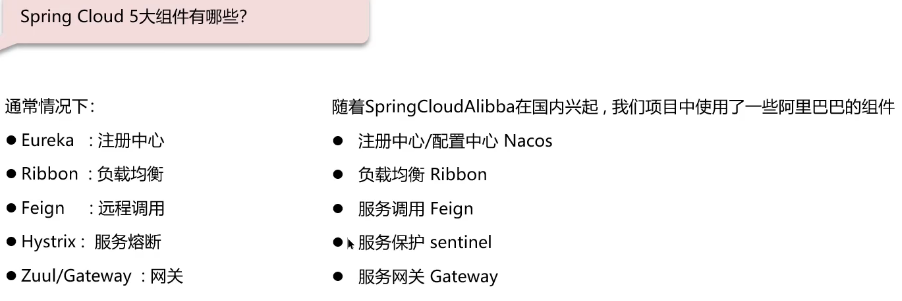
本章是早期录屏截图整理,组件表已过时(Ribbon 被移除、Hystrix 停更、Sleuth 被取代)。最新版本请看文字版:Java - 微服务篇,图只作参考。
4.1 Spring Cloud 组件
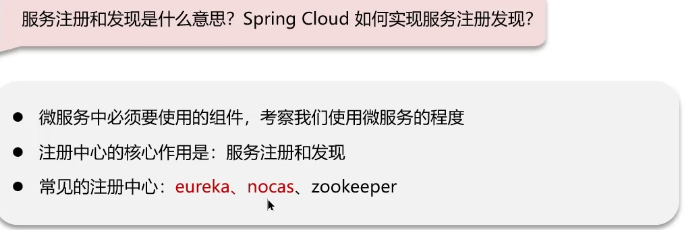
4.2 注册中心(Nacos vs Eureka)
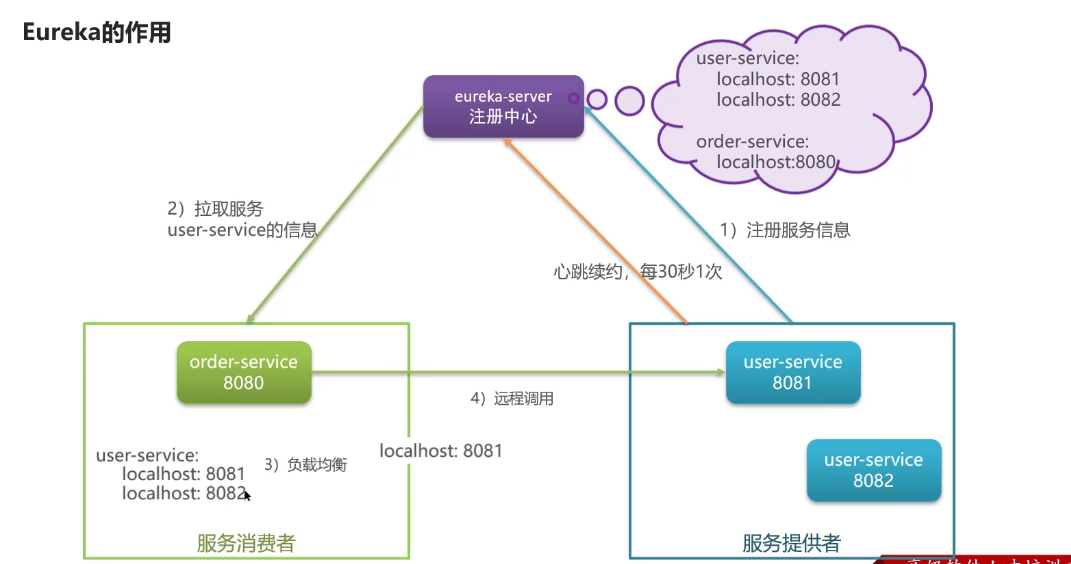
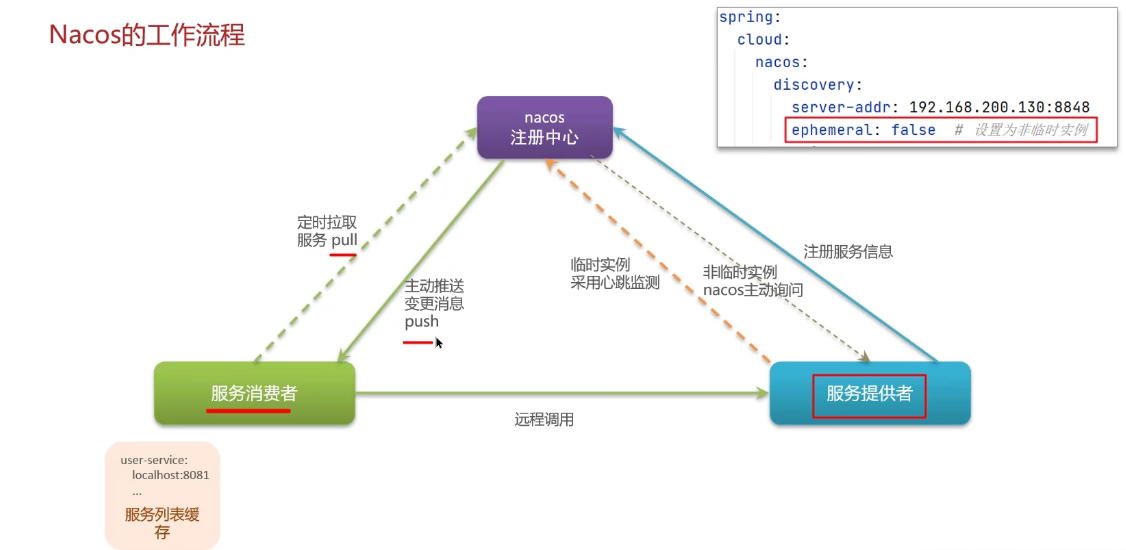
4.3 负载均衡(Ribbon → Spring Cloud LoadBalancer)
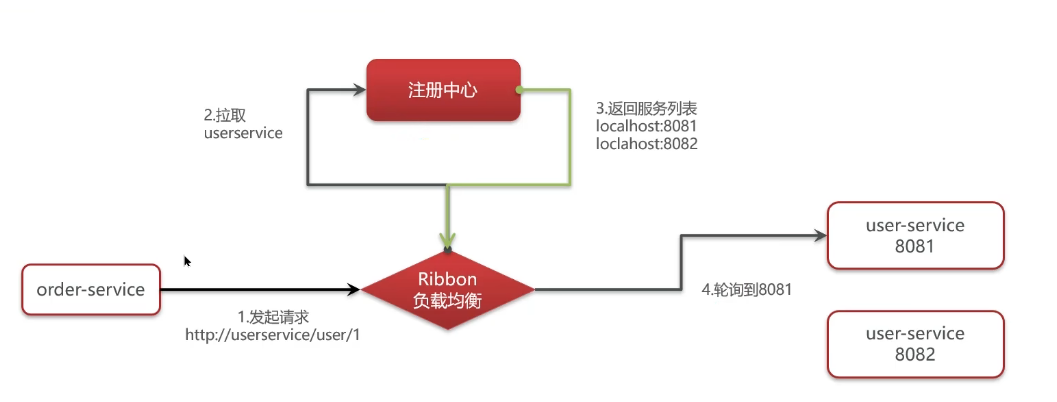
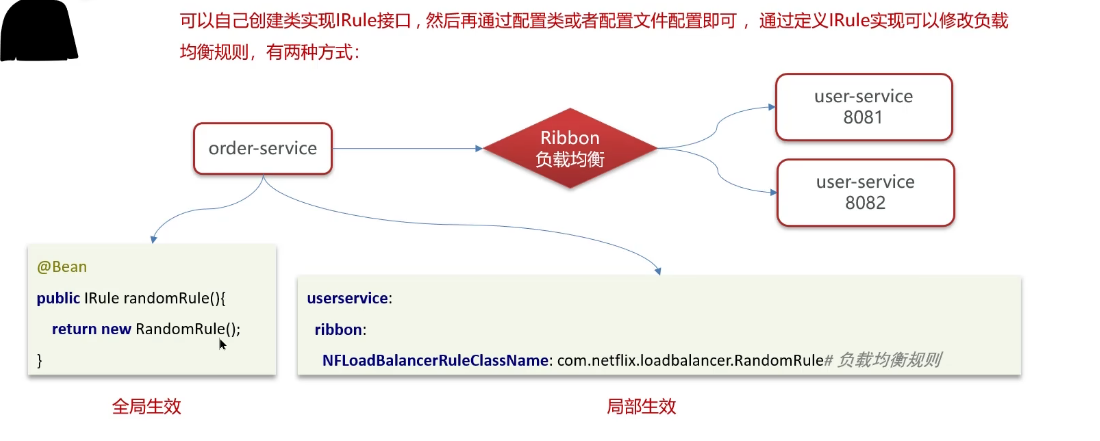
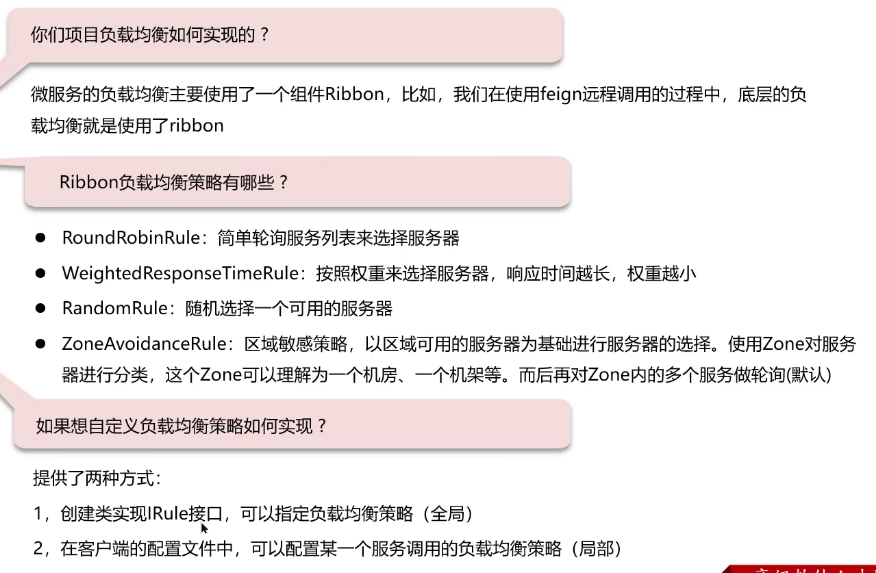
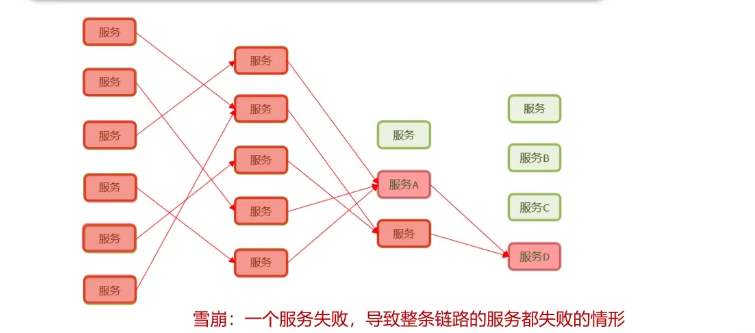
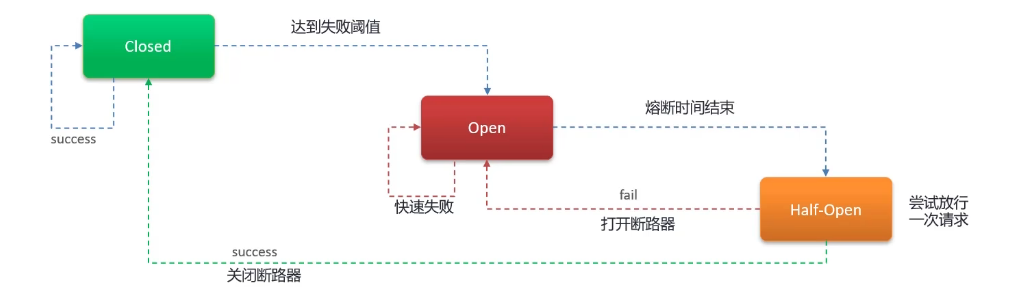
4.4 服务雪崩与熔断降级
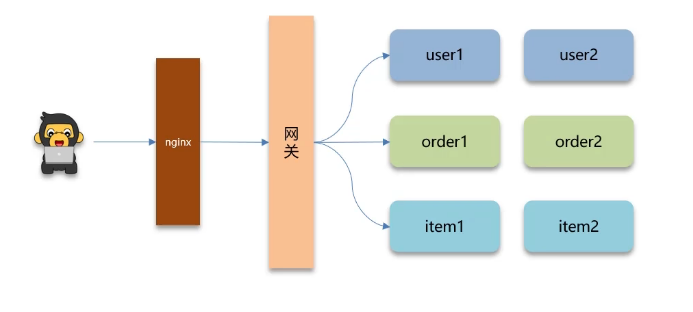
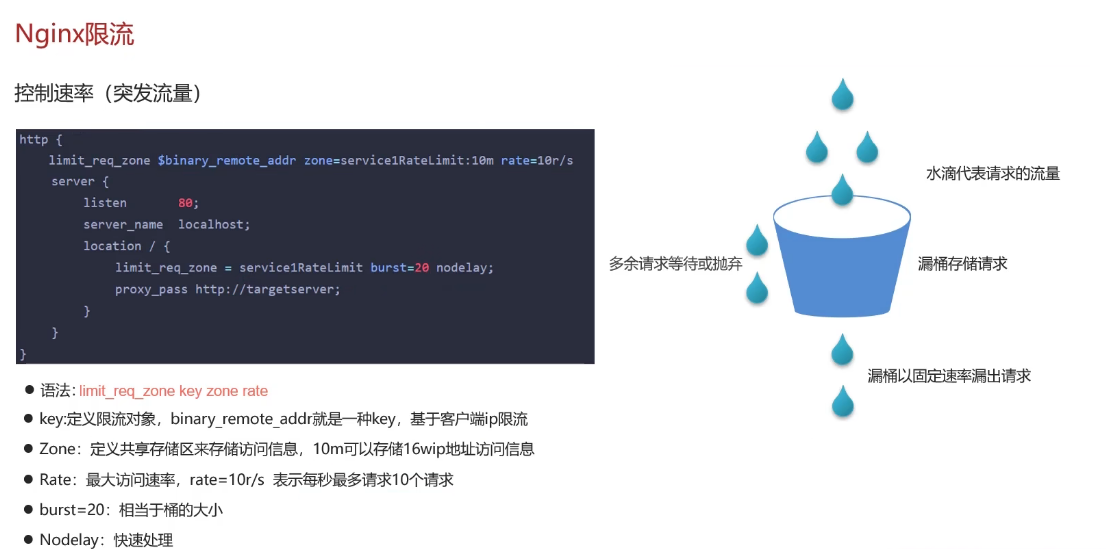
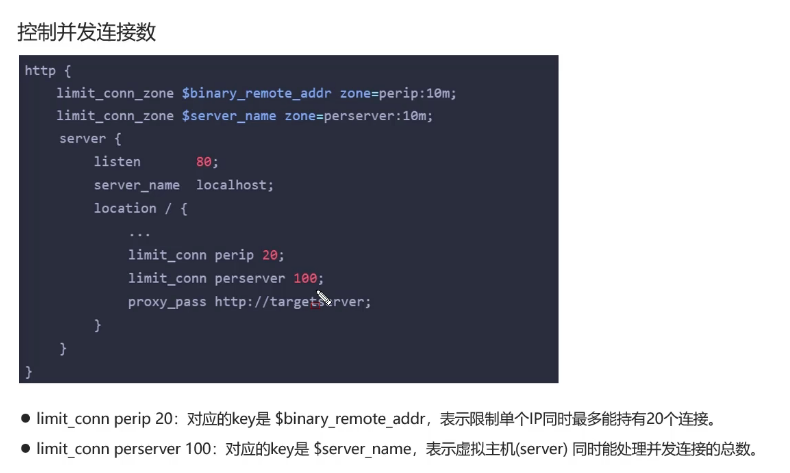
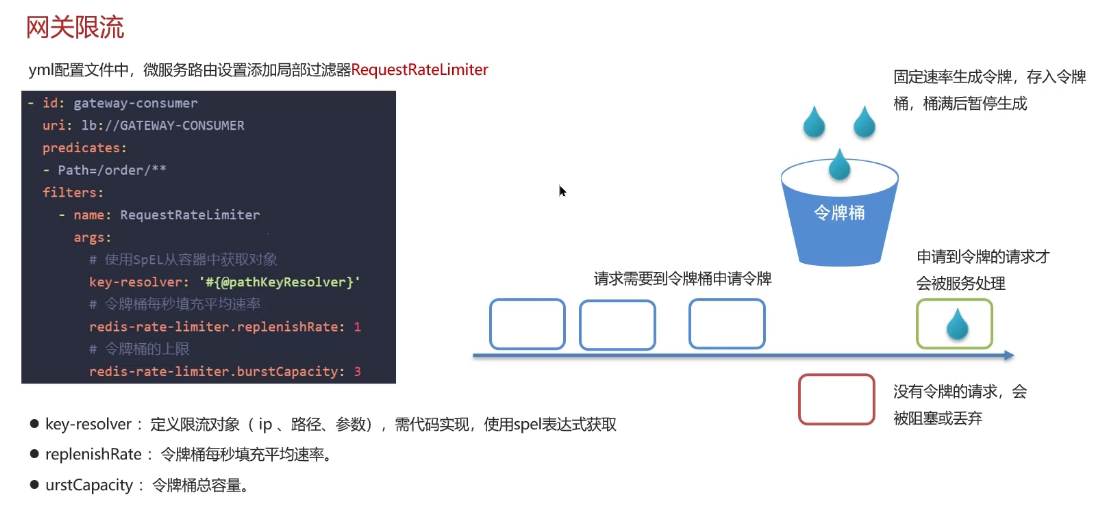
4.5 限流(Nginx / 网关)
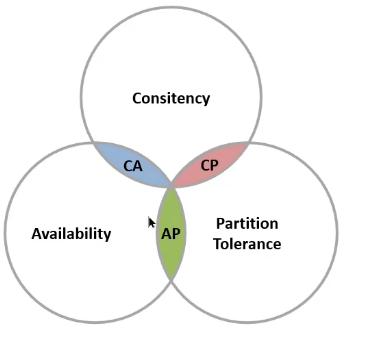
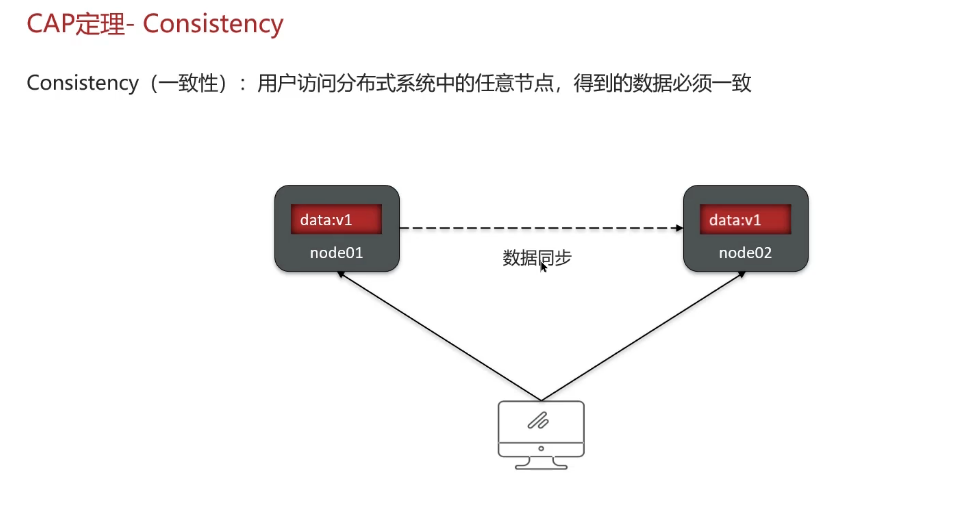
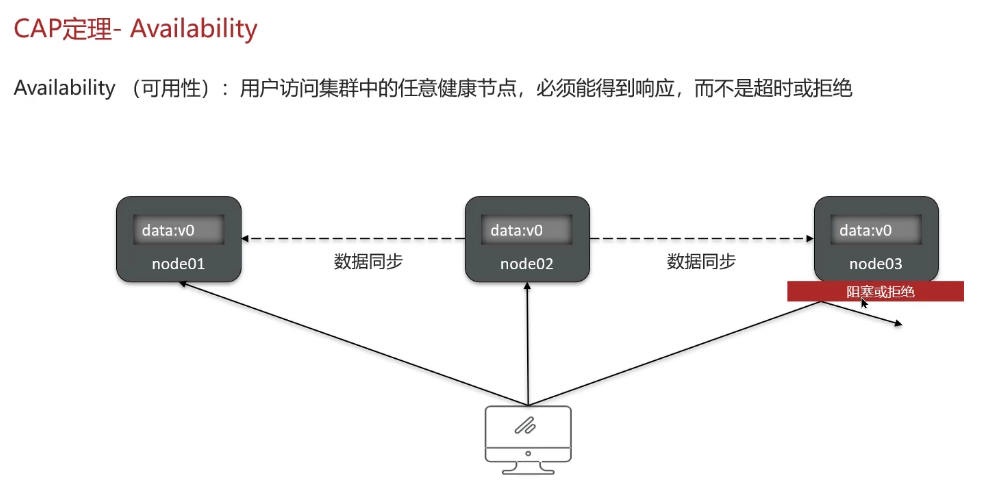
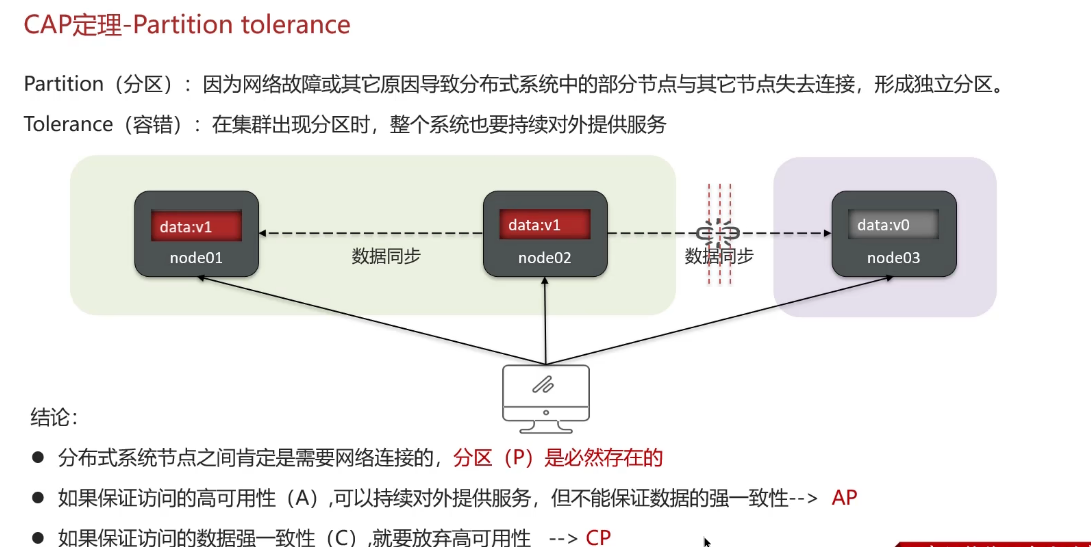
4.6 CAP 与 BASE
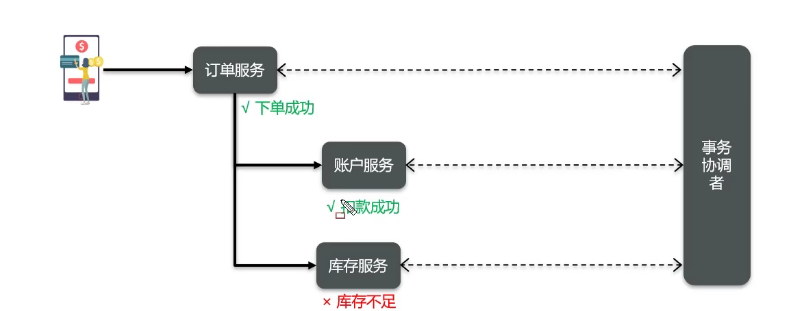
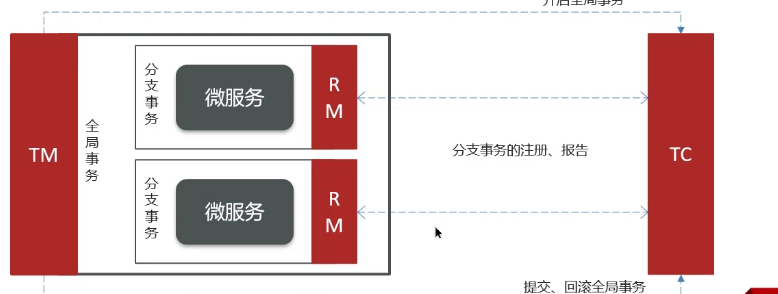
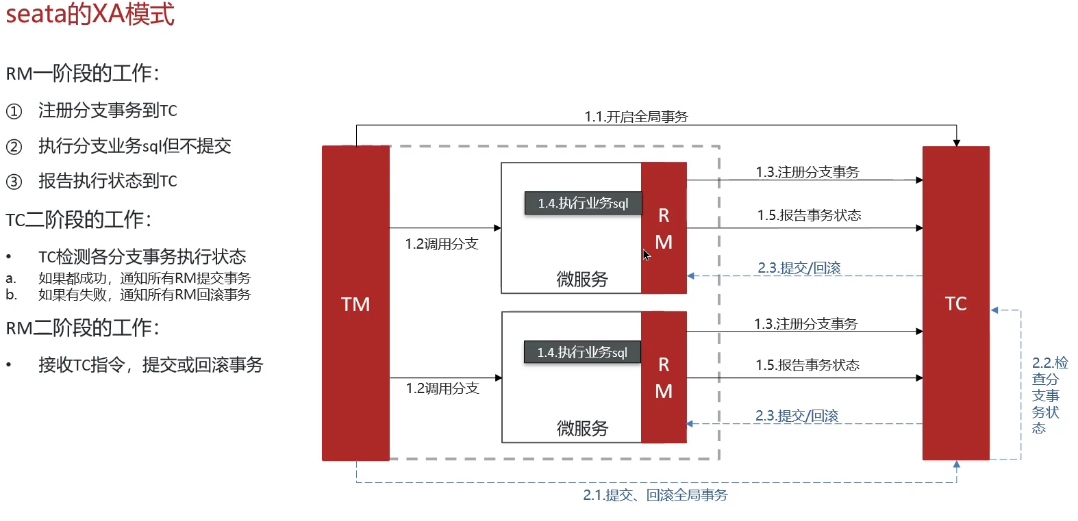
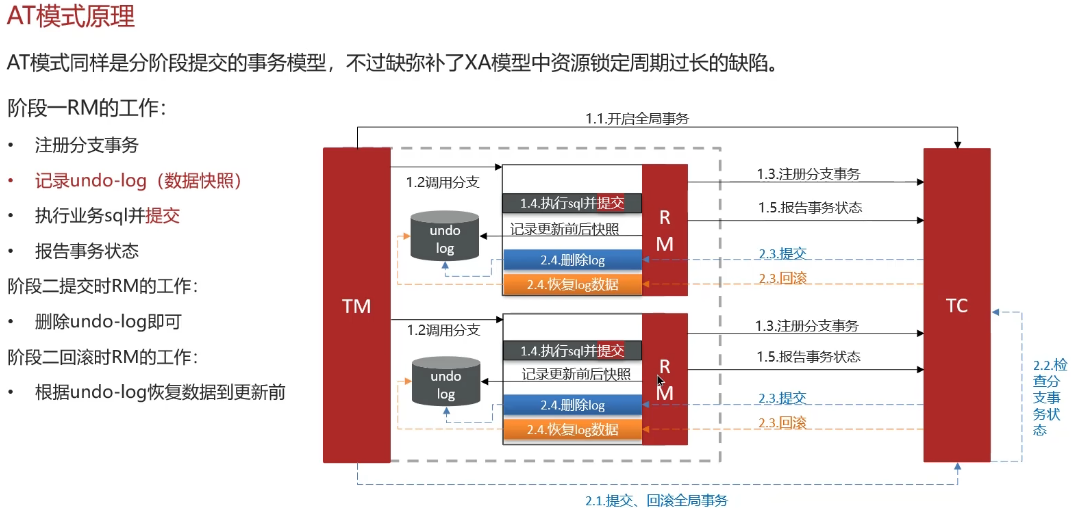
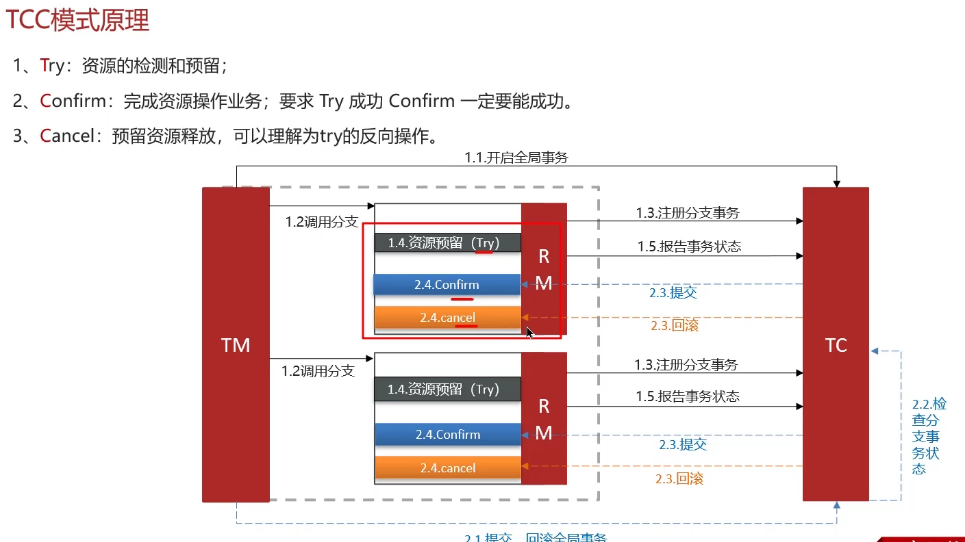
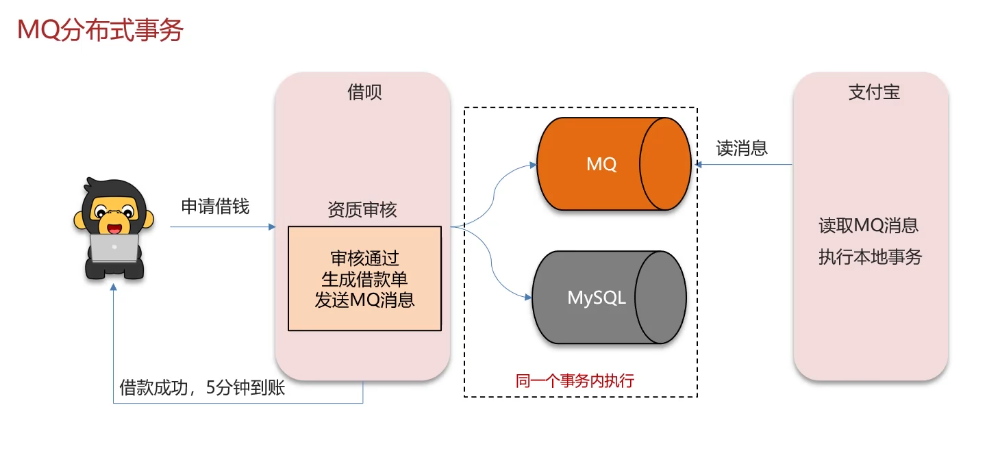
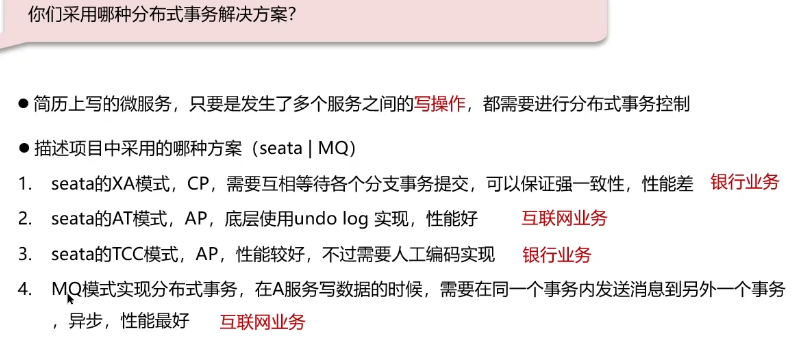
4.7 分布式事务(Seata / Saga / Outbox)
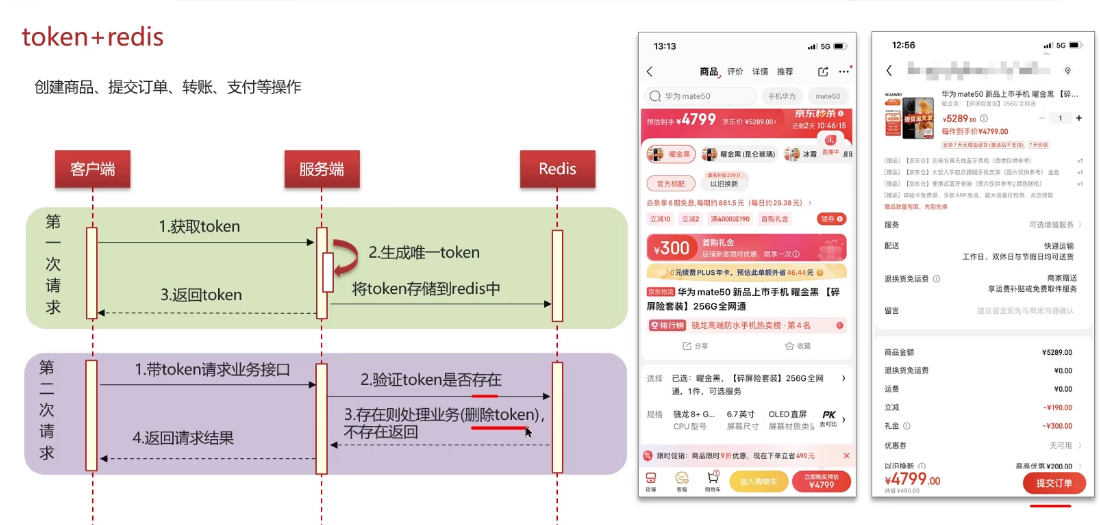
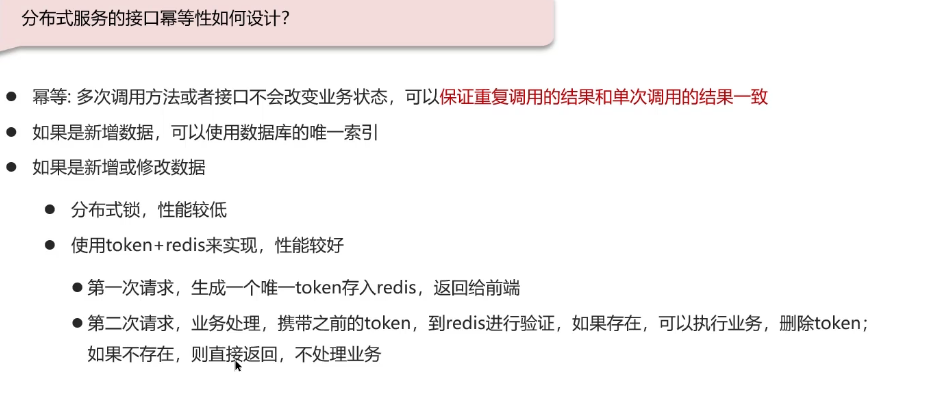
4.8 接口幂等性
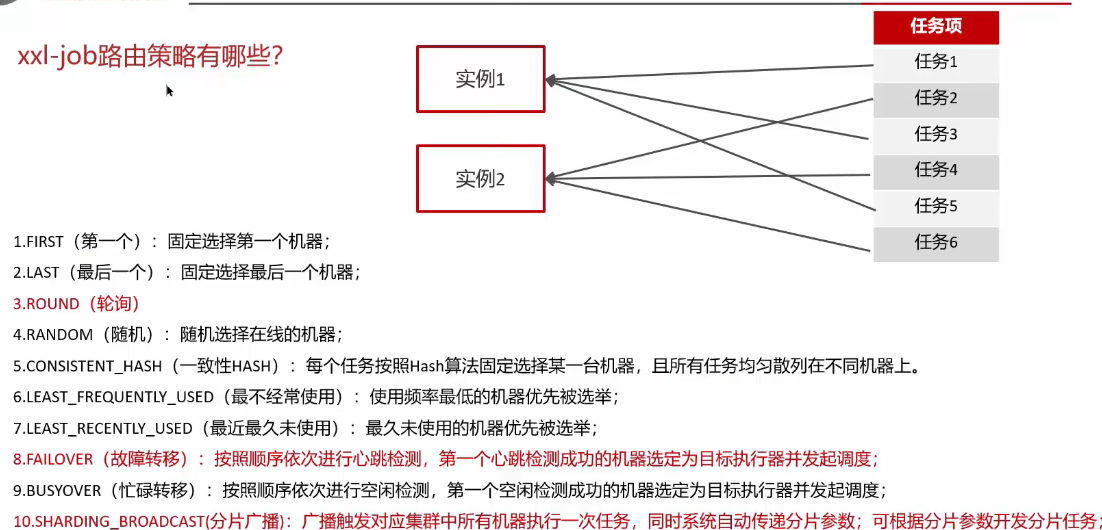
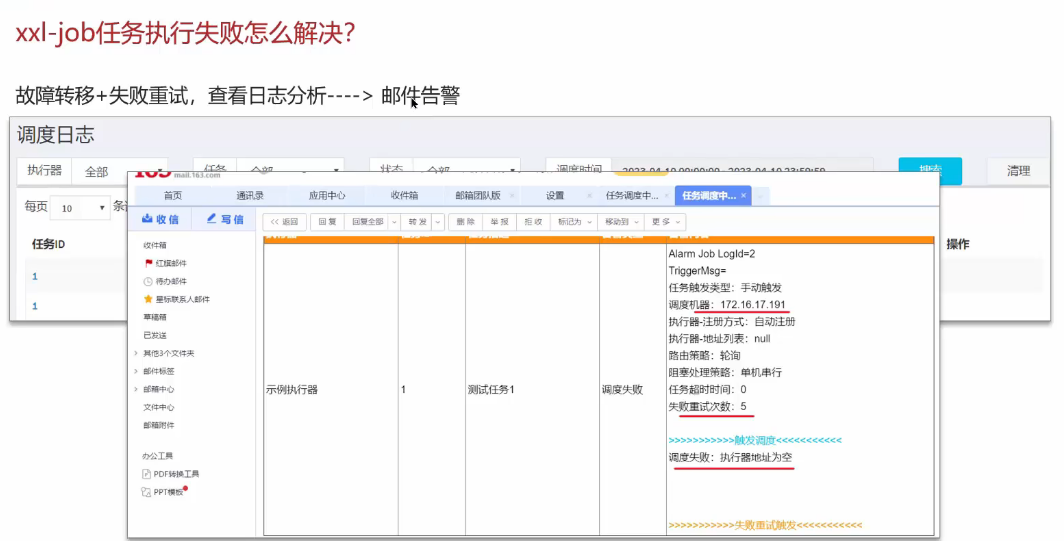
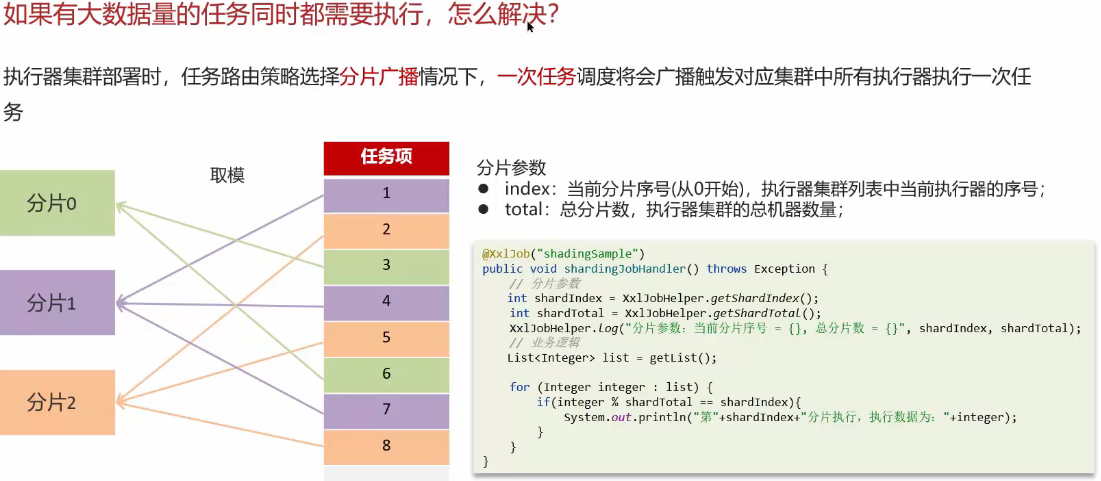
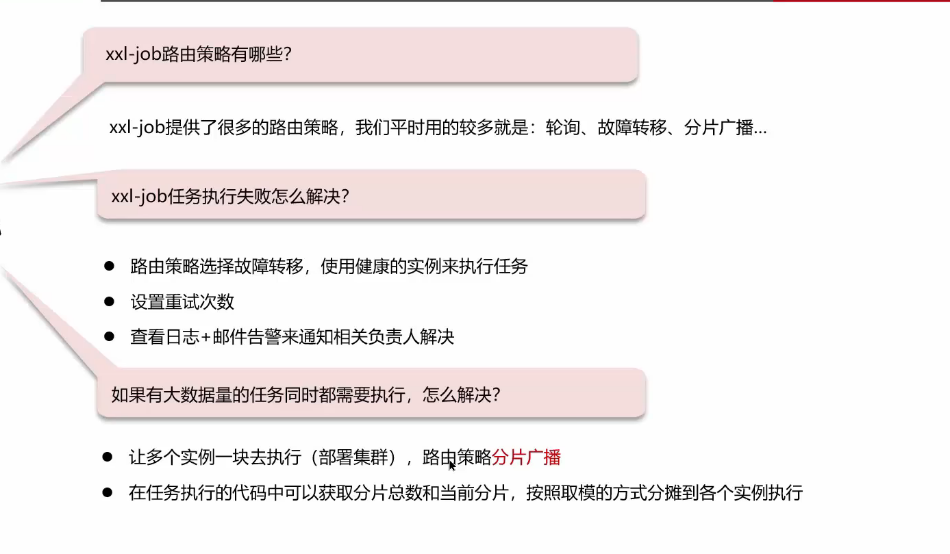
4.9 分布式任务调度(XXL-JOB)
五、消息中间件
5.1 RabbitMQ 核心概念
MQ(Message Queue)= 跨进程、异步通信的中间件。三大核心作用:系统解耦、异步处理、流量削峰。
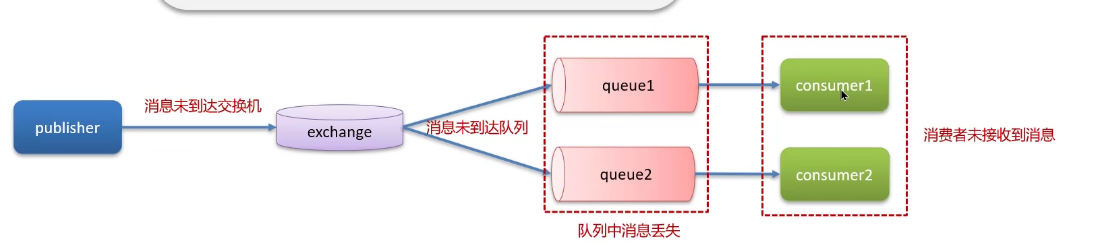
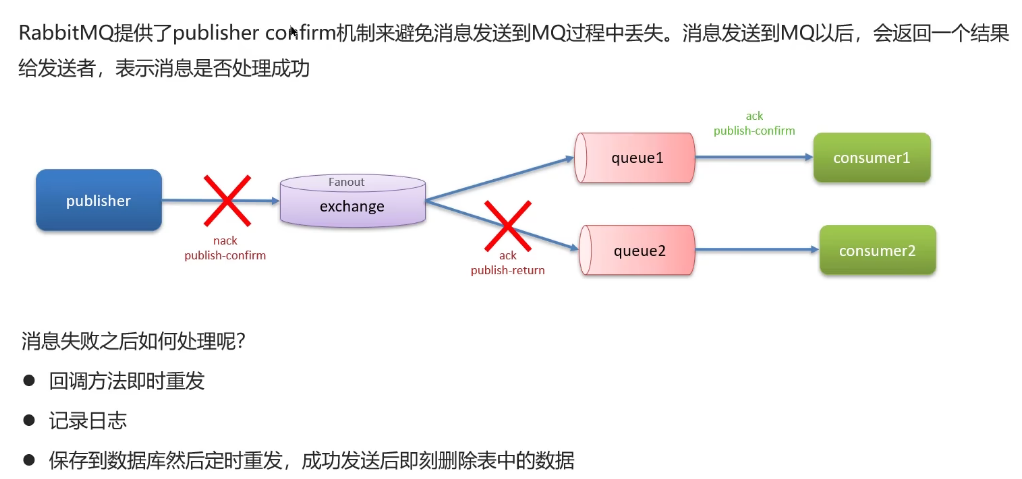
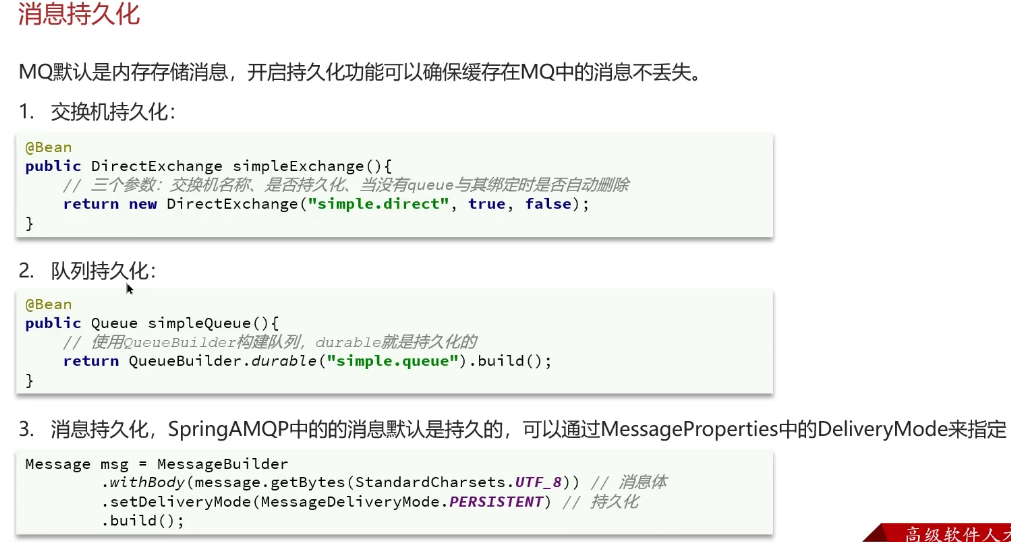
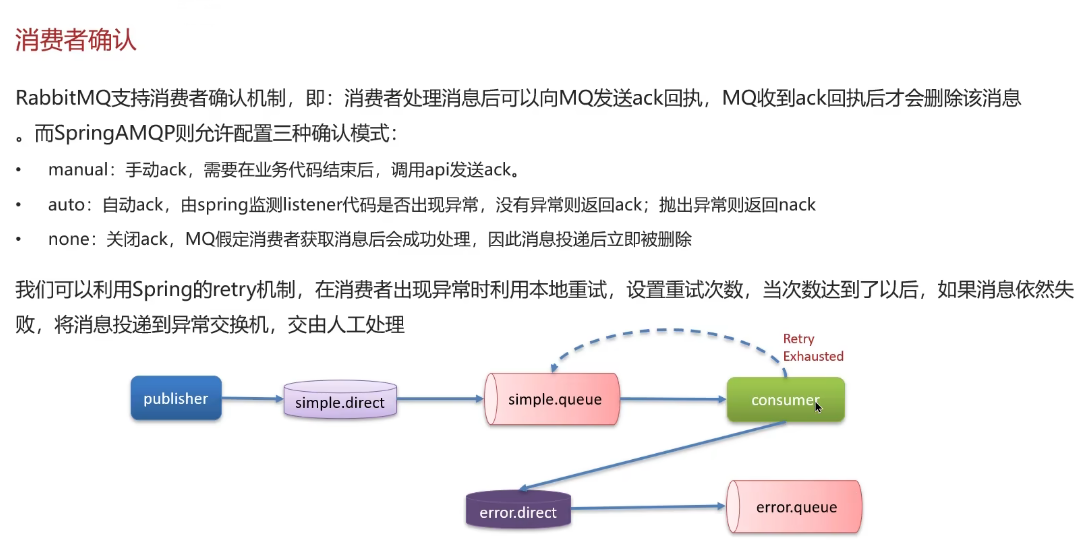
5.2 RabbitMQ 消息可靠性
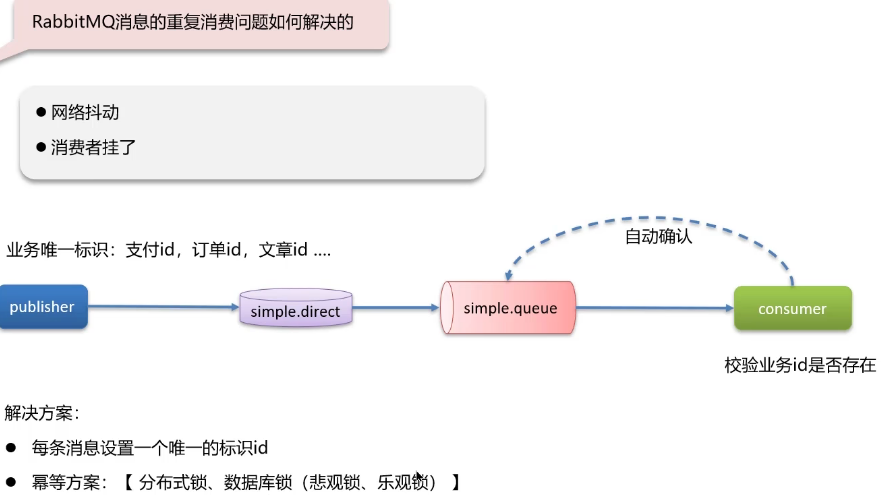
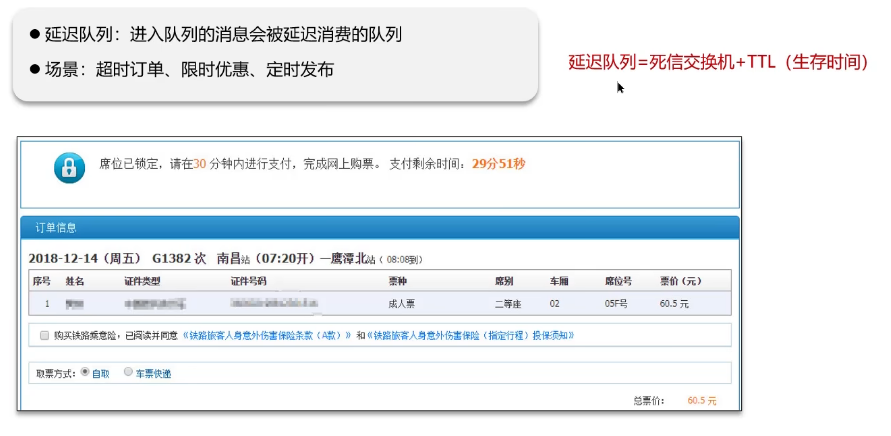
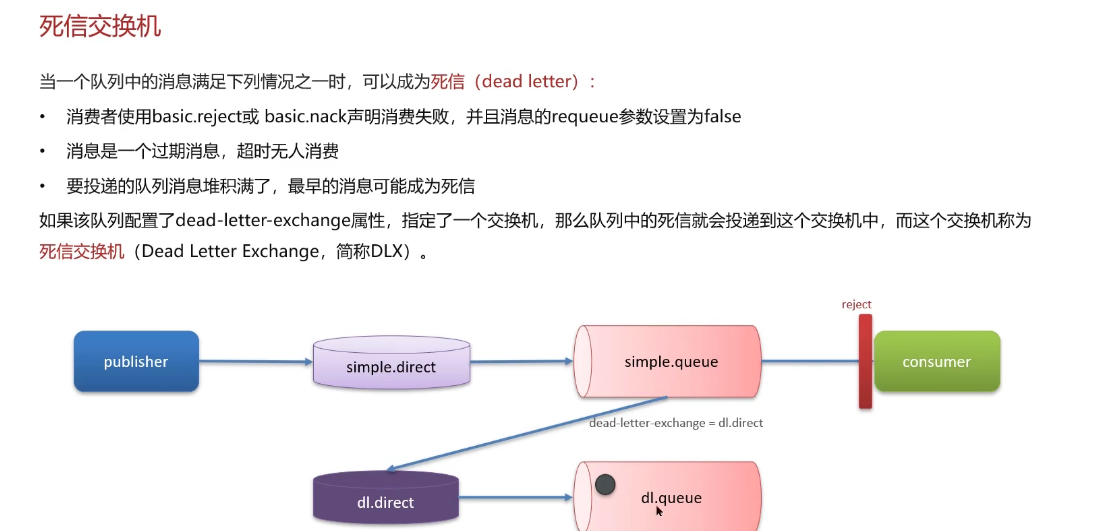
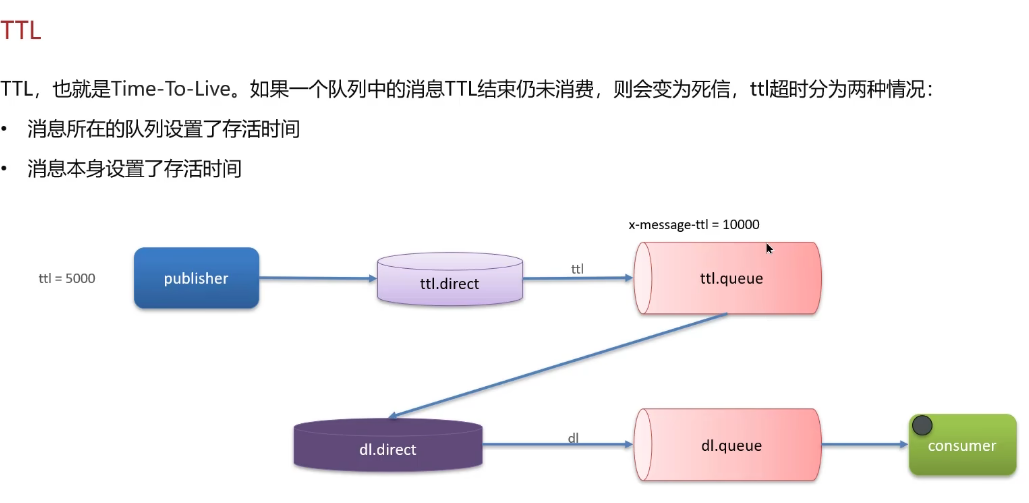
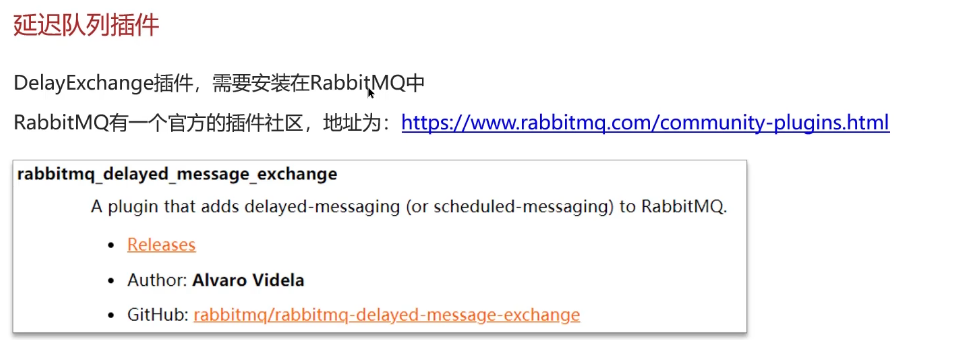
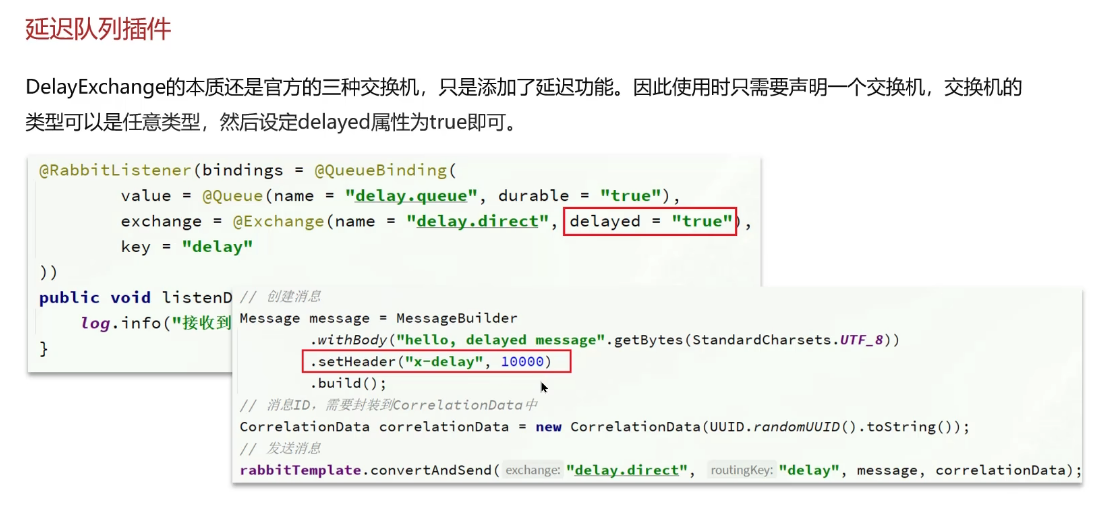
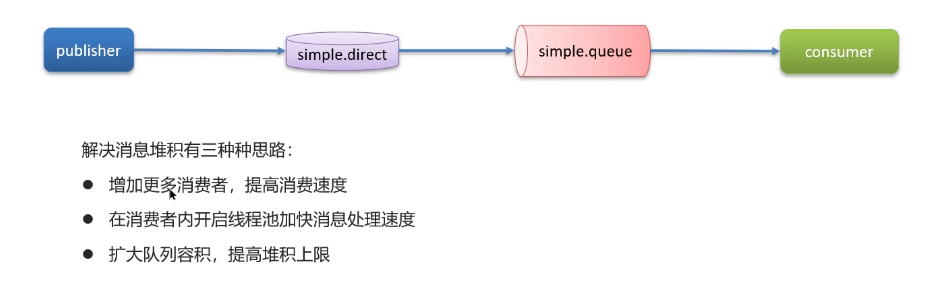
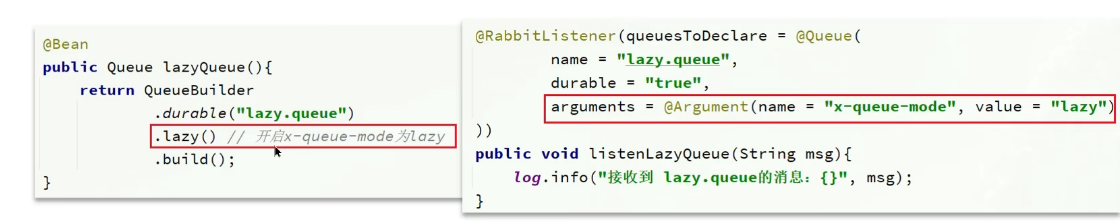
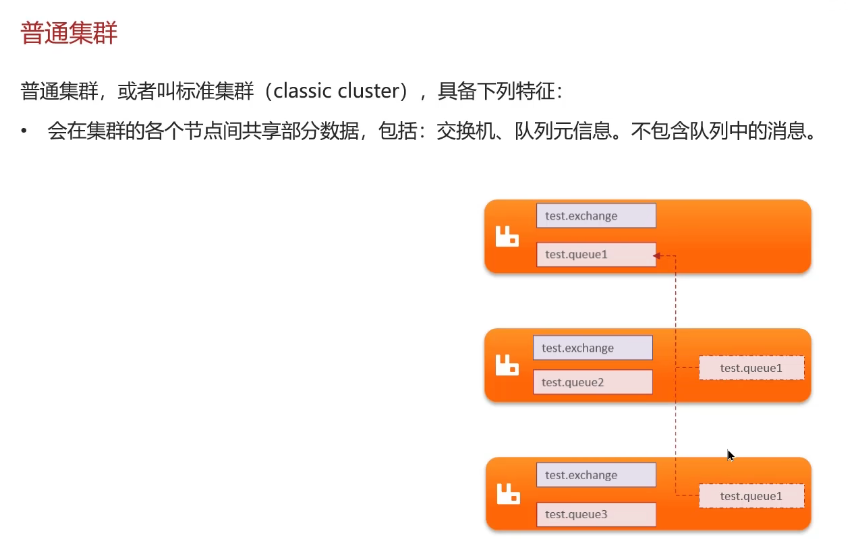
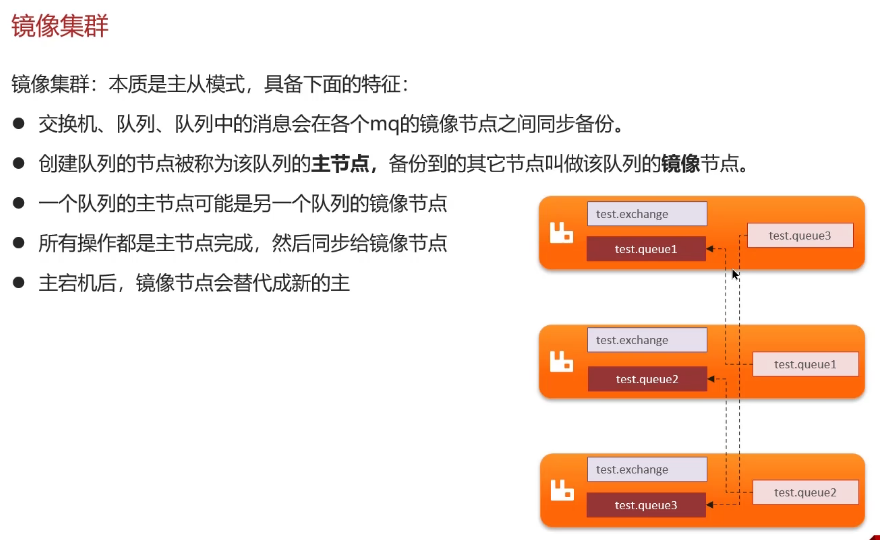
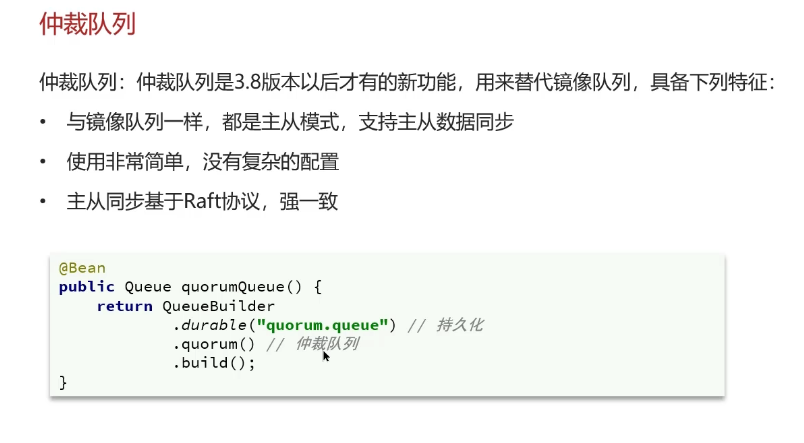
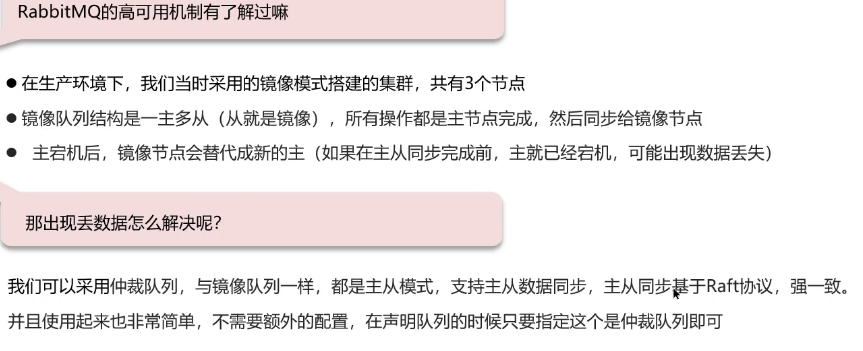
5.3 RabbitMQ 重复消费 / 死信队列 / 消息堆积
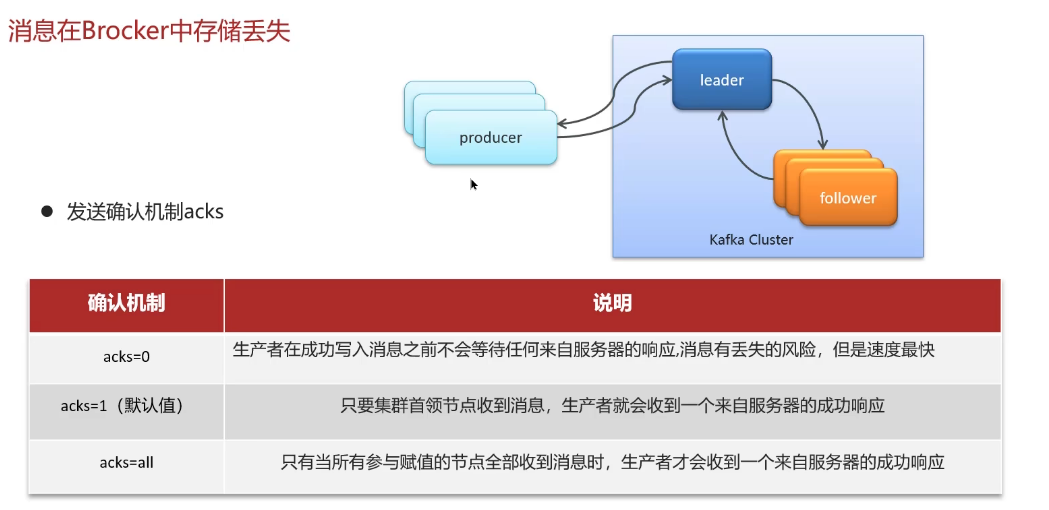
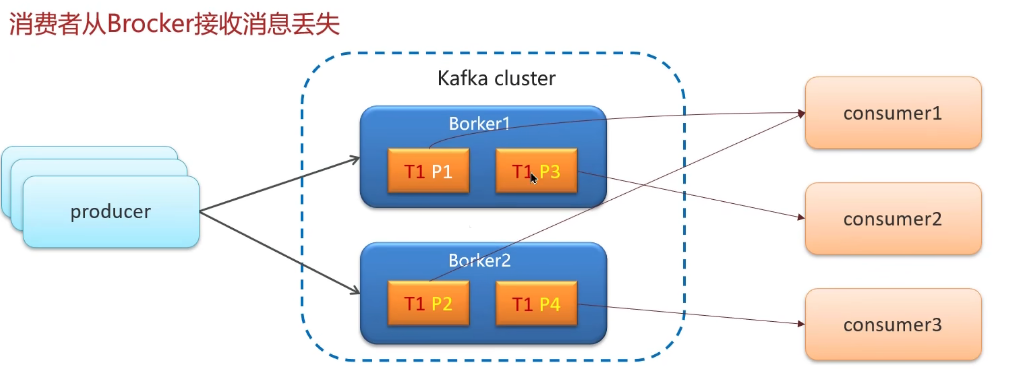
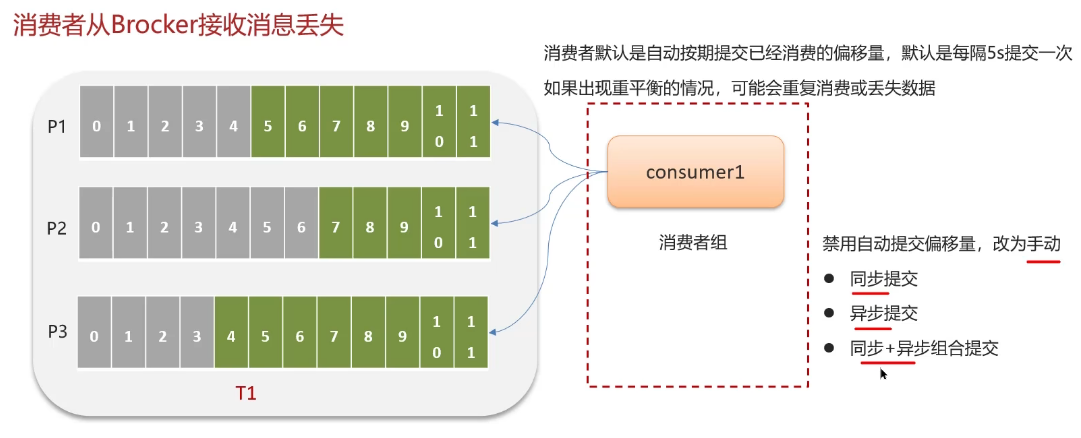
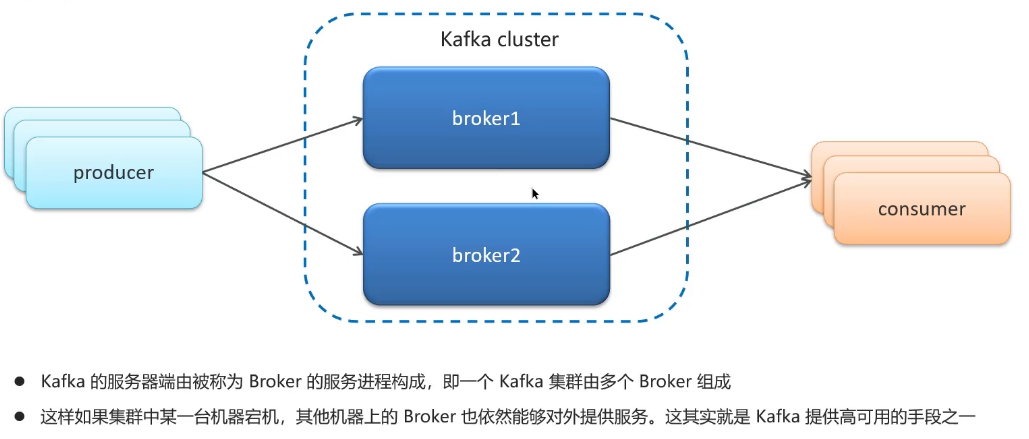
5.4 Kafka 消息可靠性
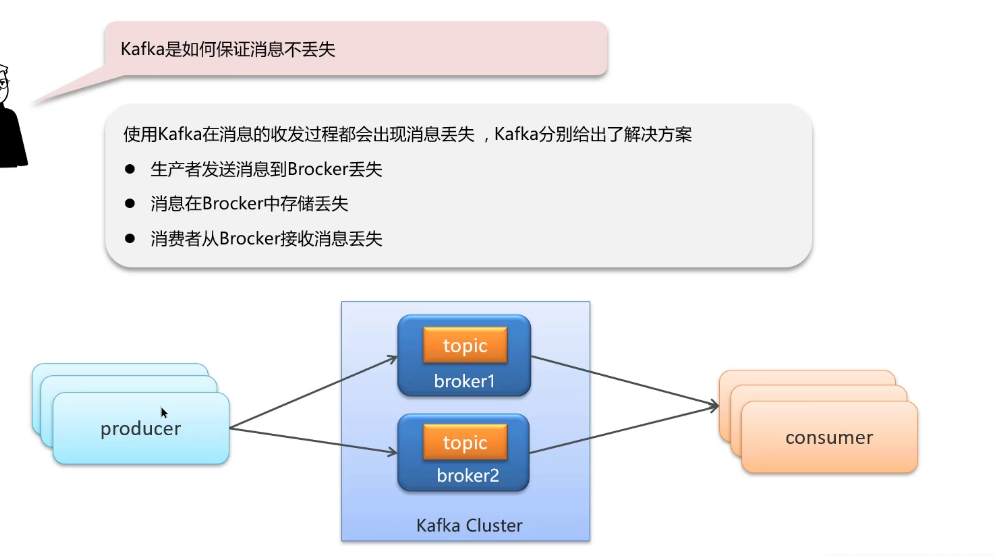
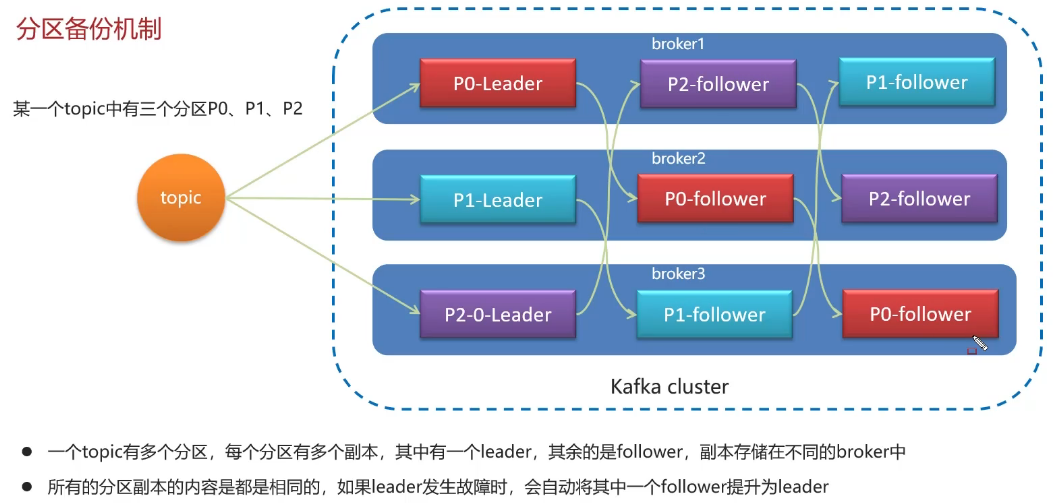
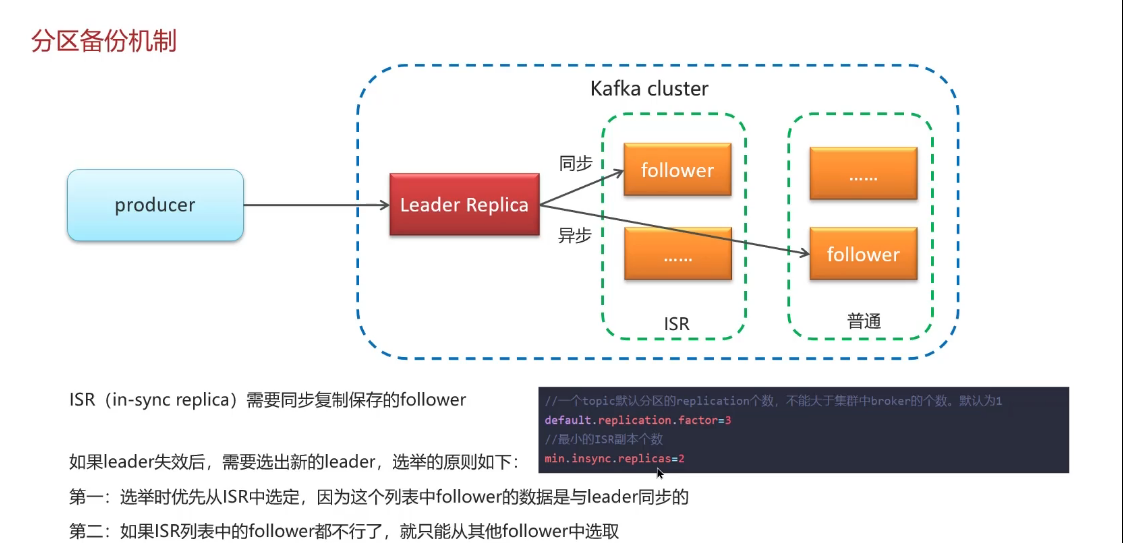
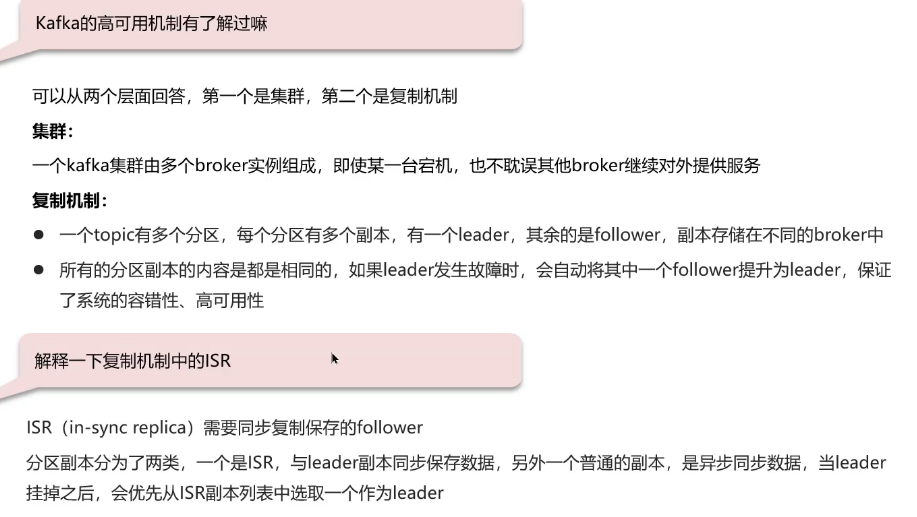
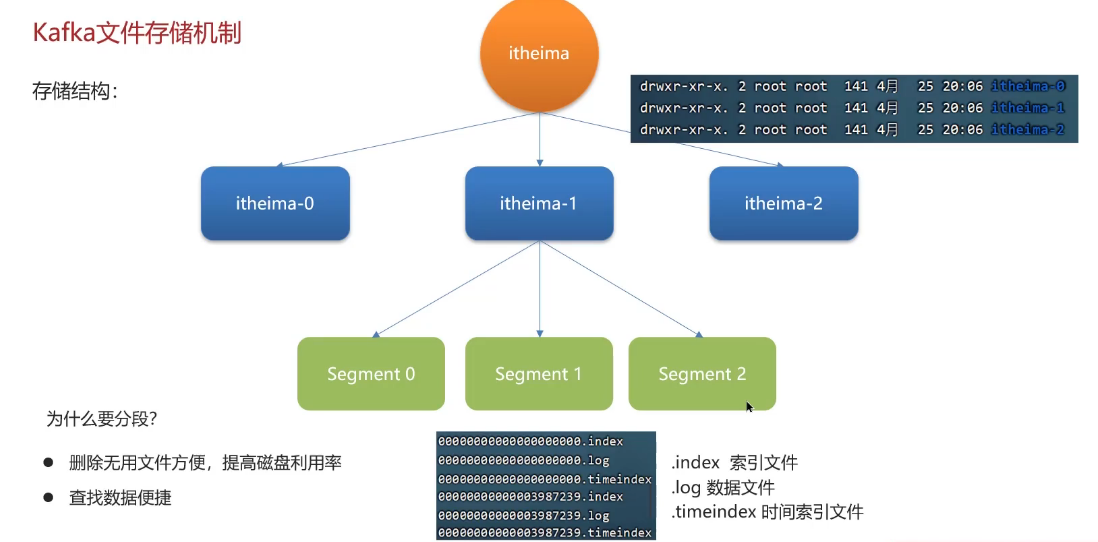
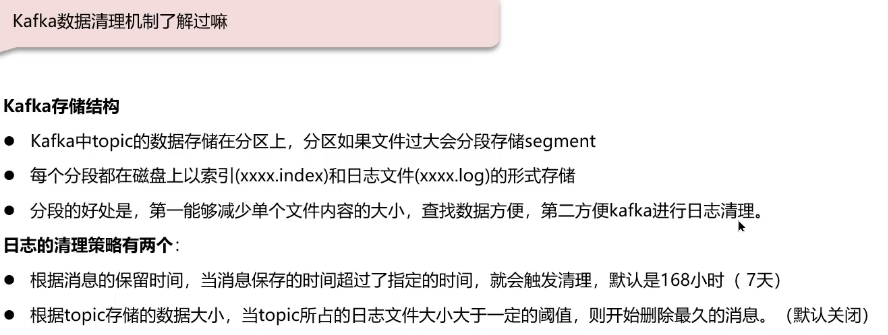
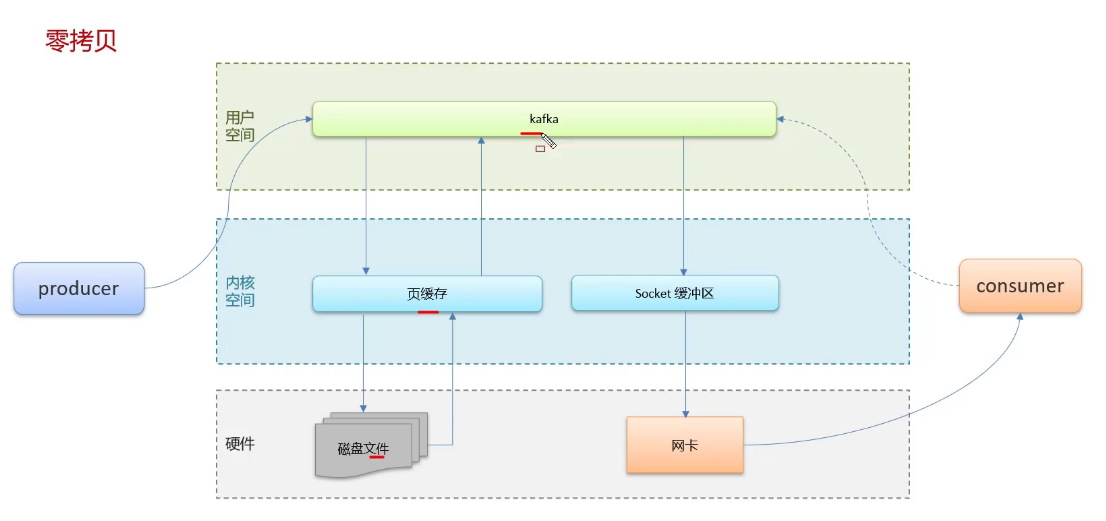
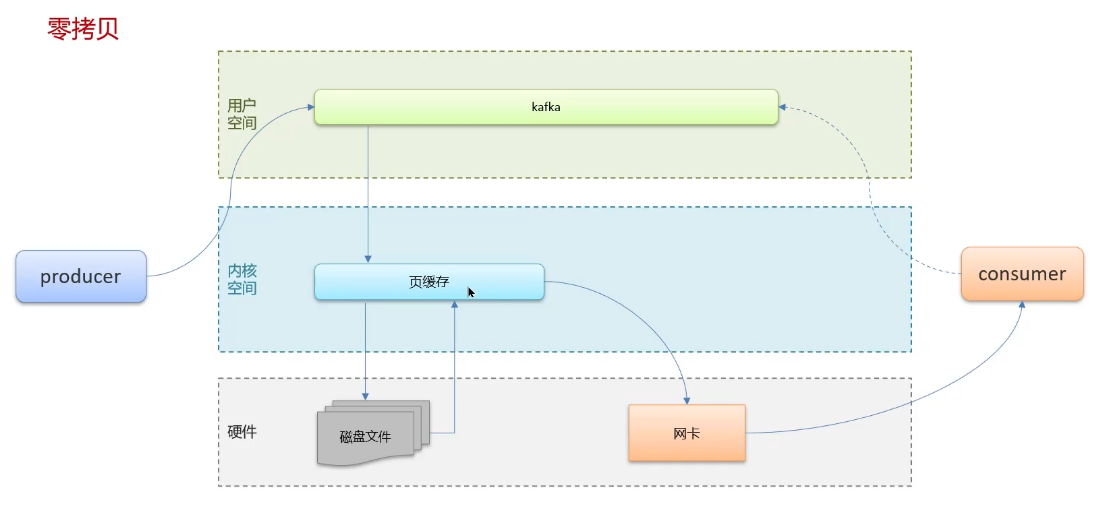
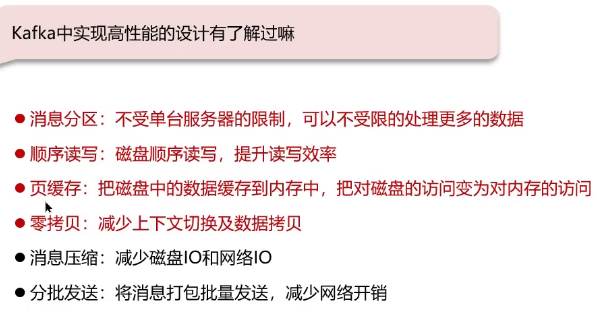
5.5 Kafka 顺序性 / 高可用 / 存储 / 高性能
六、Java 集合
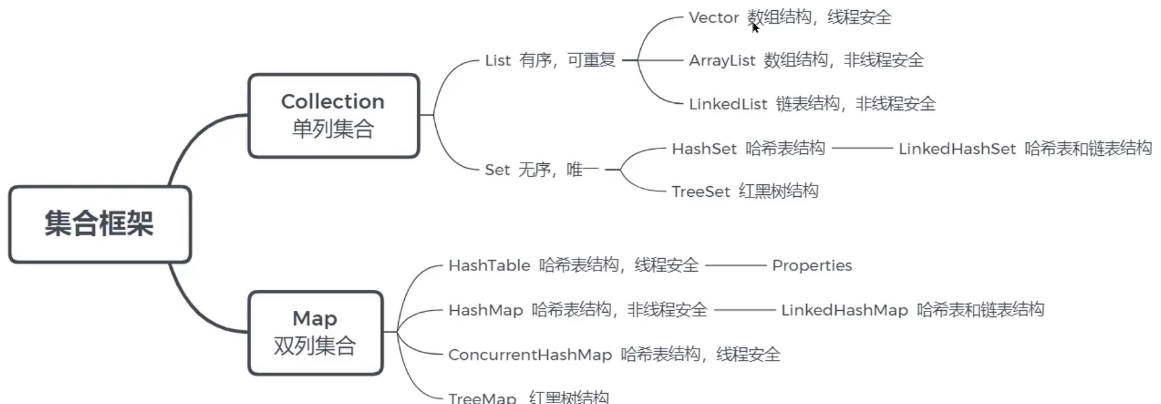
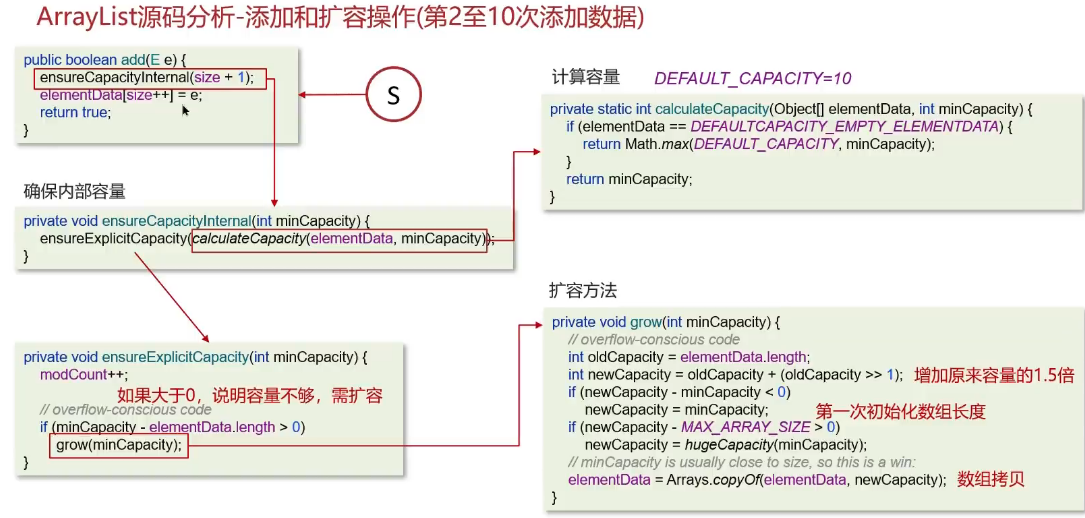
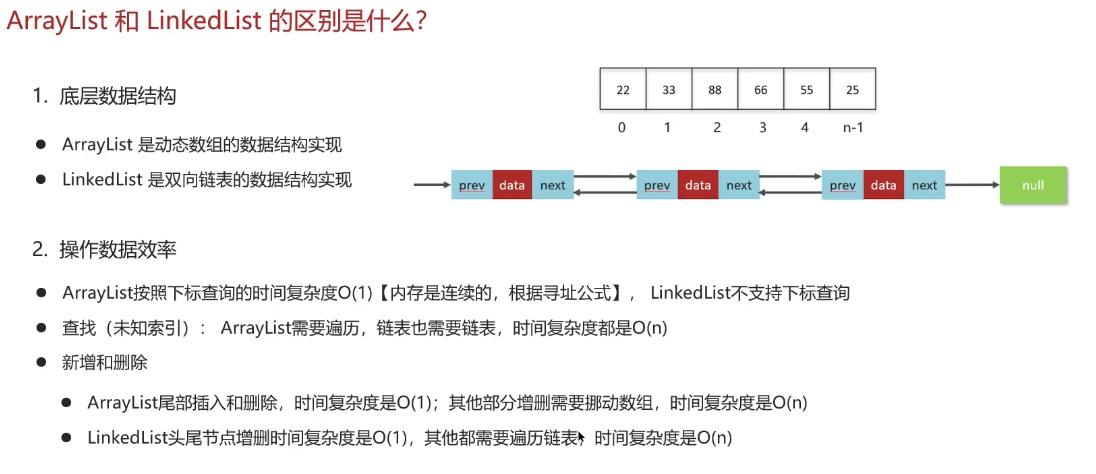
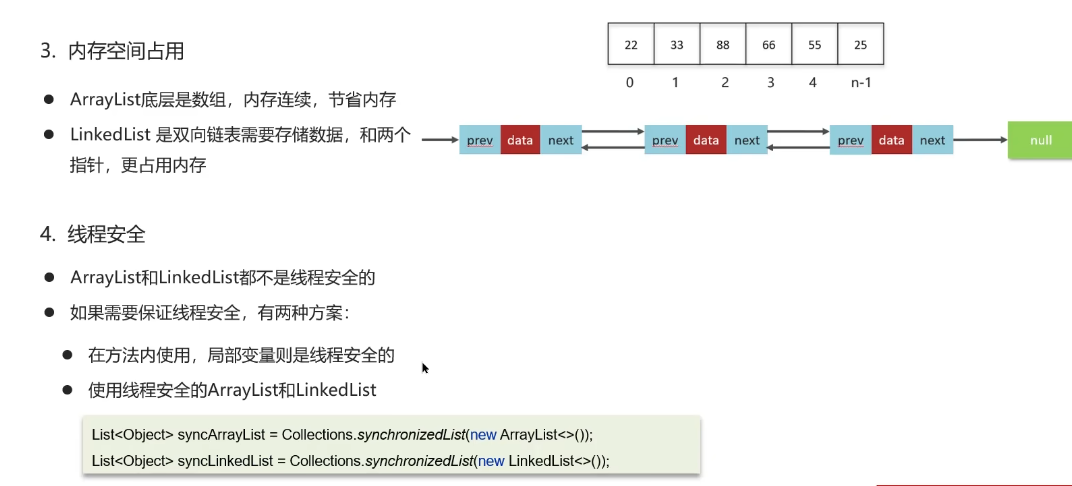
6.1 ArrayList / LinkedList
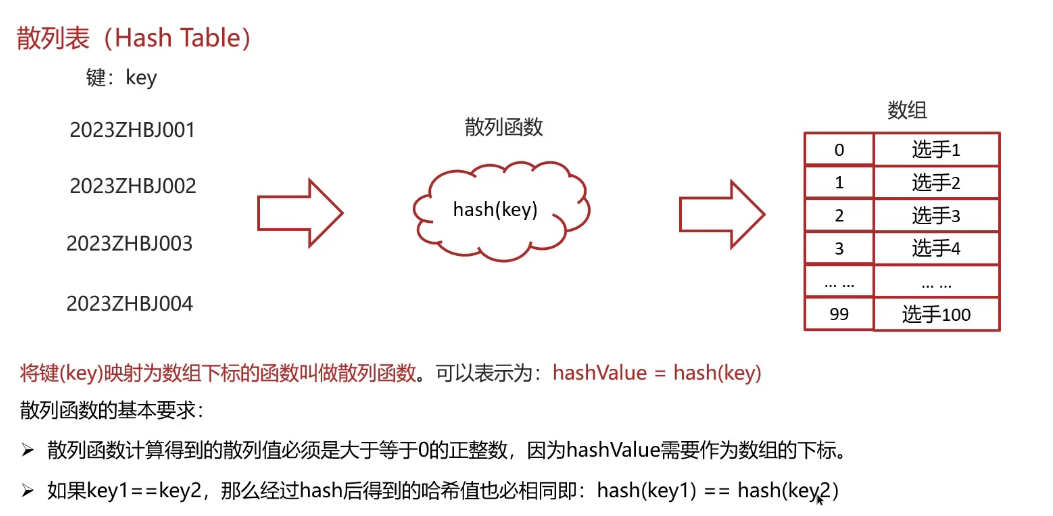
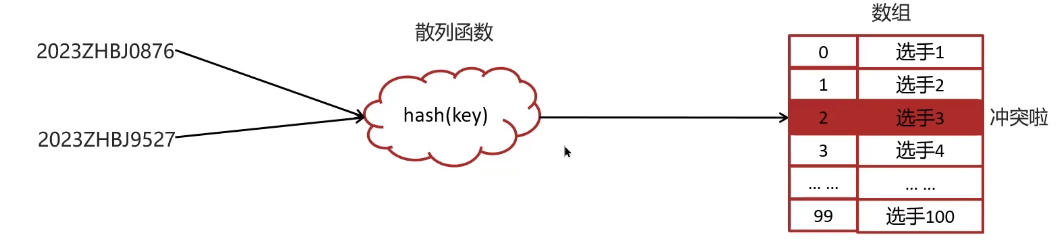
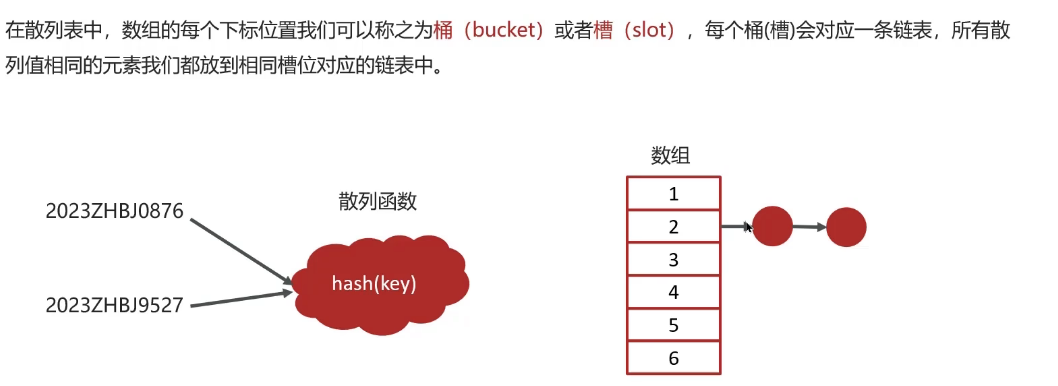
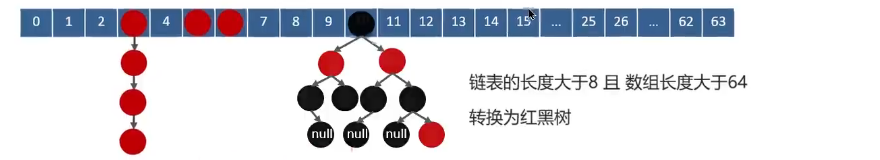
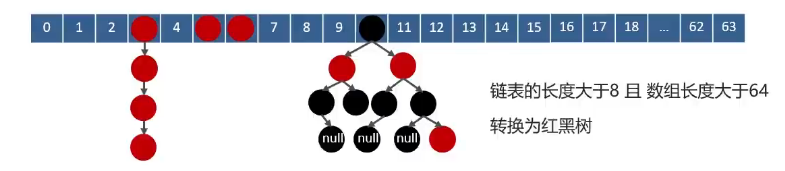
6.2 HashMap 底层原理
七、多线程
7.1 线程基础
进程 = 资源分配的最小单位;线程 = CPU 调度的最小单位。
7.2 synchronized 与锁升级
7.3 JMM / CAS / volatile
7.4 AQS / ReentrantLock
7.5 线程池
7.6 ThreadLocal
7.7 ConcurrentHashMap
7.8 并发编程三大特性
| 特性 | 说明 | 根本原因 |
|---|---|---|
| 原子性 | 操作不可分割 | i++ 实际分三步,中间可能被切换 |
| 可见性 | 一个线程对共享变量的修改对其他线程可见 | CPU 多级缓存,未及时刷回主内存 |
| 有序性 | 代码按编写顺序执行 | 编译器/处理器指令重排序优化 |
解决方案:volatile(可见性 + 有序性)+ CAS(原子性)+ 锁机制(三者皆可)。